Qué hace falta de verdad para construir una buena búsqueda de imágenes
En febrero de 2000, Jennifer Lopez llevó un vestido verde de Versace a los Grammy, y durante unas semanas fue lo más buscado en Google. Google solo podía devolver diez enlaces azules, algunos de los cuales llevaban a páginas que quizá contenían una fotografía. Eric Schmidt escribió más tarde que fue la consulta más popular que habían visto nunca y que por eso construyeron un buscador de imágenes. Google Imágenes se lanzó en julio de 2001 e indexaba unos 250 millones de imágenes.
Me gusta esta historia por la parte que la gente omite: Google Imágenes no buscaba en los píxeles. Indexaba el nombre de archivo, el texto alternativo, el pie de foto y las palabras cercanas a una etiqueta <img>, y luego comparaba la consulta con ese texto. El vestido se podía encontrar porque miles de páginas habían escrito «Jennifer Lopez», «Versace» y «Grammys» a su lado.
Veinticinco años y varias generaciones de visión artificial después, la búsqueda de imágenes sigue empezando por crear algo que se pueda buscar a partir de la imagen o a su alrededor, lo que explica muchos de los problemas prácticos que siguen.
Dirijo freedam, un gestor de recursos digitales para las fotografías, los videos y los documentos que una empresa necesita volver a encontrar. Hemos dedicado más tiempo de ingeniería a la búsqueda que a cualquier otra parte, así que este artículo reúne lo que aprendimos, para quien esté construyendo una o quiera entender por qué la suya se deja cosas sin encontrar. También hay una versión más técnica con el SQL y los parámetros; esta se queda con la forma del problema.
Una imagen no tiene palabras
Una fila de una tabla de pedidos contiene el nombre de un cliente, un ticket de soporte contiene un cuerpo de texto y un PDF puede tener una capa de texto. Un JPEG tiene tres canales de color y algo de EXIF, pero ningún término con el que una consulta de texto pueda coincidir directamente.
Por eso una búsqueda de imágenes necesita un sustituto buscable de la imagen. En la práctica, esos sustitutos se agrupan en cuatro grandes familias, y cada una cubre consultas que las demás no cubren.
Palabras que alguien escribió. Un nombre de archivo, un título, un pie de foto o el texto que rodea una imagen. Es con lo que se lanzó Google Imágenes, y con lo que se había lanzado Photo Finder de AltaVista tres años antes. Es barato y a menudo eficaz porque las personas son buenas poniendo nombres a las cosas, pero no sirve cuando una carpeta contiene solo archivos llamados DSC_0001 a DSC_4817.
Palabras de un vocabulario. Las etiquetas, las categorías y las taxonomías son precisas y filtrables, por lo que las usan las agencias de imágenes de stock y las bibliotecas corporativas. También son costosas de mantener, y el vocabulario tiende a alejarse del lenguaje que la gente usa para buscar.
Palabras que escribió una máquina. Esto incluye el OCR de la imagen, las descripciones de un modelo de visión y las transcripciones de video. El ESP Game de Luis von Ahn usó una versión humana en 2004: dos desconocidos veían la misma imagen, ganaban puntos cuando escribían la misma palabra y su coincidencia se convertía en una etiqueta. Google lo licenció como Google Image Labeler en 2006 y lo mantuvo cinco años. Hoy los modelos pueden producir estas etiquetas a escala, aunque el resultado tiene ruido y carece de contexto de negocio: un modelo puede reconocer una zapatilla sin saber que es el SKU 4471-RD.
Ninguna palabra. Una imagen se puede representar como números y compararse con otras representaciones numéricas. El QBIC de IBM lo hizo en 1995 permitiendo bosquejar una distribución de colores. TinEye en 2008 y la búsqueda por imagen de Google en 2011 popularizaron la forma inversa: aportar una imagen y encontrar copias de ella. CLIP puso después texto e imágenes en el mismo espacio numérico, de modo que una consulta como a dog on a skateboard podía encontrar una imagen que nadie había etiquetado con esas palabras. Es la base de la mayoría de las demos recientes de «búsqueda con IA».
Nada de esta lista reemplazó a lo anterior. Google Imágenes sigue usando el texto circundante y las agencias de imágenes siguen pagando a personas para etiquetar, porque cada representación responde preguntas que las otras no pueden. Nuestro primer error fue tratar una de ellas como la respuesta principal en lugar de combinarlas.
Lo que la investigación perseguía entretanto
La investigación que corría en paralelo a esos productos dedicó unos treinta años a una pregunta: cómo reducir la distancia entre las características visuales y el significado que expresa una consulta. Los modelos recientes avanzaron mucho, aunque el resultado es más acotado de lo que sugieren muchas demos.
La expresión «recuperación de imágenes basada en el contenido» (content-based image retrieval, CBIR) se acuñó en 1992, por Toshikazu Kato en el Laboratorio Electrotécnico de Japón, para la idea de que se podían buscar imágenes por lo que había en ellas y no por lo que alguien había escrito sobre ellas. QBIC de IBM fue el primer sistema serio que lo intentó. Podía comparar histogramas de color, texturas y formas, y se consultaba dibujando un bosquejo. Photo Finder de AltaVista, en 1998, construido con una empresa llamada Virage, llegó a lanzar al público un botón de «visualmente similar», y el público, de forma abrumadora, escribió palabras en su lugar.
La razón recibió nombre en 2000, en un artículo de revisión de Smeulders y colaboradores que desde entonces cita todo investigador del campo: la brecha semántica. La distancia entre lo que un sistema informático puede extraer de los píxeles (esta región es verdosa, este borde es vertical) y lo que una persona quiere decir con una consulta (un vestido, una celebridad, una ceremonia de premios). Los histogramas de color viven a un lado de esa brecha. Todas las consultas que alguien escribe de verdad viven al otro. Durante los veinte años siguientes, el programa de investigación fue, en esencia, «cerrar la brecha».
Se cerró por etapas, y cada etapa acabó en un producto. Las características locales (SIFT, 1999) y el truco de «Video Google» de 2003, que trataba los parches visuales como palabras y los indexaba como texto, son los antecesores directos de TinEye y de la búsqueda inversa de imágenes de Google: coincidencia de la misma imagen a escala web, un problema distinto y más fácil que el del significado. ImageNet, en 2009, puso a disposición un millón de imágenes etiquetadas, y AlexNet, en 2012, mostró que una red neuronal entrenada con ellas producía características que superaban a todos los descriptores diseñados a mano. Luego, en 2013, un artículo de Google llamado DeViSE hizo algo que hoy parece obvio y entonces parecía extraño: entrenó las características de la imagen para que cayeran cerca de los vectores de palabras de sus etiquetas, de modo que la imagen de una cosa y el nombre de esa cosa quedaban juntos en un mismo espacio, y un modelo podía reconocer categorías para las que nunca había sido entrenado. CLIP, en 2021, fue esa idea llevada a 400 millones de pares imagen-texto extraídos de la web. La brecha que había sido el problema central del campo desde 1992 quedó, para las consultas descriptivas, en su mayor parte cerrada.
El matiz importante es descriptivas. CLIP puede encontrar a dog on a skateboard, pero no puede encontrar de forma fiable SS26-HERO-03, entender que la búsqueda actual está limitada a una colección, ni informar de que un límite de candidatos excluyó 953 resultados. Esos son problemas de producto y de recuperación, que se resuelven con otro conjunto de herramientas: BM25 para el ranking por palabras clave, reciprocal rank fusion para combinar listas de resultados y HNSW para la búsqueda rápida de vecinos más cercanos entre vectores. La recuperación semántica es útil, pero sigue siendo un componente del motor de búsqueda.
Lo que la gente espera de verdad
Antes de la arquitectura, quiero detenerme un poco en los usuarios, porque de sus expectativas salen la mayoría de las restricciones de diseño, y no son las que elegiría un ingeniero de búsqueda.
La mayoría de las personas aprendió la interacción con Google Imágenes, donde los resultados llegan rápido, la cuadrícula casi nunca termina y no existe una única respuesta correcta para sunset. Si una de las primeras imágenes sirve, la búsqueda ha cumplido.
La biblioteca de fotos de una empresa es otra cosa, y el modelo mental de Google resulta allí activamente perjudicial, de maneras que me costó años ver.
En la biblioteca de una empresa, la respuesta suele ser más específica: el atardecer de la sesión de Lisboa, con el puente, usado en el informe anual del año pasado. Puede haber un resultado correcto o doce, así que una cuadrícula de 400 atardeceres plausibles no es especialmente útil.
Muchas consultas de una biblioteca no son descripciones en absoluto. Los registros contienen 4471-RD, SS26-HERO-03, números de factura y nombres de modelo, que son habituales en un DAM y poco adecuados para la búsqueda semántica, porque los vecinos más cercanos de un SKU suelen ser otros SKU.
La gente también busca dentro de una carpeta, una colección o una campaña. «Encuentra las fotos principales de esta sesión» es una petición común, y los límites de candidatos pueden hacer que este tipo de búsqueda quede incompleta sin que la página de resultados parezca rota.
«Sin resultados» también puede ser útil. Si nadie ha fotografiado la nueva tienda de Madrid, el usuario quizá necesite encargar el trabajo, mientras que llenar la cuadrícula con fotografías de Barcelona y Sevilla solo oculta esa información.
Por último, la gente actúa sobre conjuntos completos de resultados: «Selecciona los 1240 resultados y aplica esta fecha de caducidad de licencia». Eso solo es seguro cuando 1240 es realmente el conjunto completo.
Las personas tienden a juzgar una búsqueda por sus primeros resultados, así que las coincidencias que faltan son difíciles de notar. Una consulta puede perder dos tercios de sus recursos relevantes y aun así devolver una página plausible en noventa milisegundos. En una biblioteca que todos, nosotros incluidos, consideraban razonablemente buena, la medición encontró fallos totales en quince de sesenta consultas realistas, ninguno de los cuales se había reportado.
Para la biblioteca de una empresa, entonces, una buena búsqueda de imágenes necesita encontrar recursos específicos, manejar identificadores además de descripciones, funcionar dentro de un ámbito, devolver un resultado vacío honesto e informar de si los límites de candidatos pueden haber excluido coincidencias. El resto de este artículo explica cómo abordamos esos requisitos.
La indexación fija el límite
Al principio dedicamos demasiado tiempo al ranking porque es la parte visible de la búsqueda, pero muchos de nuestros problemas de exhaustividad empezaban en la indexación. Una consulta no puede recuperar un término que nunca se colocó en la representación buscable del recurso.
Por eso compilamos un documento de búsqueda almacenado para cada recurso e idioma, y lo reconstruimos cuando el recurso cambia. Incluye el título, el nombre de archivo, la descripción, el autor, el copyright, la ubicación, las palabras clave, las etiquetas y descripciones generadas, el OCR, los metadatos personalizados, los nombres de colecciones, los nombres confirmados de personas y los subtítulos de video. Los términos de vocabulario controlado incluyen además a sus ancestros, de modo que un recurso etiquetado como espresso machine se puede encontrar mediante small appliances o kitchen sin que el usuario conozca la taxonomía.
Dos aspectos de este documento resultaron importar mucho más de lo que esperaba.
El primero es la ponderación. Un título debe contar más que una línea de OCR y, con un índice de palabras clave que no tiene noción de campos, representamos ese peso repitiendo el texto importante en el documento. Funciona, pero también cambia la longitud del documento. Como la puntuación por palabras clave normaliza por longitud, la repetición puede favorecer a los documentos más cortos en caso de empate. En una consulta por un nombre de lugar, once videos de producto superaron a las fotografías de producto: los documentos de los videos tenían entre 155 y 493 caracteres, mientras que los documentos más ricos de las imágenes tenían entre 746 y 1280.
El segundo es la tokenización, que decide dónde termina un término y empieza el siguiente. Encontramos un ejemplo pequeño pero útil en etiquetas de compatibilidad como Galaxy A52/A52S: PostgreSQL trataba el valor como un único token parecido a una ruta, así que una consulta con a52 no encontraba recursos que visiblemente llevaban esa etiqueta. Normalizar los separadores antes de indexar resolvió el caso. La lección general es sencillamente inspeccionar los términos que produce el analizador cuando el texto está presente pero la exhaustividad es inesperadamente baja, porque reconstruir los mismos tokens no cambiará el resultado.
Dos formas de buscar, una sola base de datos
Una vez que tienes el documento, hay dos formas útiles de buscar en él, y son buenas en cosas opuestas.
La primera es la búsqueda por palabras clave con BM25. El nombre no ayuda mucho (viene de «Best Match», y 25 es el número de versión que se quedó), pero la idea es simple: un documento puntúa más alto cuando un término de la consulta aparece más veces, cuando el término es raro en la biblioteca y cuando el documento es corto. La fórmula data de 1994 y sigue siendo eficaz para términos exactos como 4471-RD. Su debilidad es el vocabulario: cuando el fotógrafo escribió autumn y quien hace marketing busca fall, puede que no haya ningún término en común que ordenar.
La segunda es el enfoque estilo CLIP: convertir el documento y la imagen en puntos de un espacio de 768 dimensiones, poner la consulta en el mismo espacio y devolver los puntos cercanos. Esto puede encontrar team celebrating outdoors cuando nadie usó esas palabras, pero un índice vectorial siempre devuelve k vecinos, incluso cuando ninguno es una buena coincidencia. Por eso un umbral de distancia forma parte del diseño de la recuperación y no es un ajuste opcional del ranking.
Ejecutamos ambos dentro de PostgreSQL, en la misma instancia que los recursos: BM25 con pg_textsearch y los vectores con pgvector y un índice HNSW. Así se evita un servicio de búsqueda aparte y su pipeline de sincronización.
El compromiso es directo. Un recurso nuevo puede volverse buscable en la misma transacción que lo inserta, mientras que los permisos, los embargos y los derechos de uso siguen siendo cláusulas WHERE normales en lugar de un segundo modelo de autorización. Las instalaciones autoalojadas también tienen un servicio con estado menos que operar. A cambio, la forma de la consulta importa mucho: en un caso, referenciar dos veces la misma subconsulta convirtió una consulta de 6 ms en una de 7,3 segundos porque el planificador perdió el límite de filas necesario para un escaneo de índice top-k. Gran parte del trabajo consiste, por tanto, en revisar planes y mantener visibles para PostgreSQL los límites previstos.
Los embeddings provienen de modelos de texto y visión de nomic entrenados para compartir un espacio, y se ejecutan en un sidecar autoalojado para que las imágenes de los clientes no salgan de la instalación. Dos detalles operativos importaron. Primero, los modelos usan prefijos de tarea: los documentos se incorporan como search_document y las consultas como search_query, por lo que esas entradas necesitan cobertura de pruebas, ya que un prefijo incorrecto reduce la calidad sin producir ningún error. Segundo, guardamos en caché brevemente los intentos fallidos de embedding de consultas, para que la búsqueda recurra a la recuperación léxica en lugar de contactar con un sidecar no disponible en cada pulsación de tecla.
¿Cómo de cerca es suficientemente cerca?
El canal vectorial necesita un corte a partir del cual un vecino deja de considerarse coincidencia. Esperábamos un único umbral, pero el valor útil variaba con la longitud de la consulta y no era monótono.
| Consulta | Distancia coseno máx. |
|---|---|
| 1 palabra | 0,35 |
| 2 palabras | 0,42 |
| de 3 a 5 palabras | 0,45 |
| de 6 a 10 palabras | 0,48 |
| más de 10 palabras | 0,40 |
Ambos extremos son estrictos, por razones opuestas. Una sola palabra como chair tiene un vecindario semántico gigantesco: con un umbral laxo coincide con todas las fotografías de interiores de la biblioteca, llena la página y parece fiable mientras es inútil. Una consulta muy larga, que en la práctica es alguien que pega un título de producto entero, produce un embedding vago y promediado que queda débilmente cerca de todo; si aflojas el umbral ahí, obtienes todo el corpus, en orden de confianza. La franja intermedia, donde la consulta es lo bastante específica como para significar algo y lo bastante corta como para seguir significándolo, es donde la búsqueda semántica se gana el sitio.
Las consultas de una sola palabra reciben una regla adicional: un resultado también debe tener una coincidencia léxica. Sin ella, los términos de nicho tienden a llenar la página con imágenes semánticamente cercanas, haciendo que un resultado vacío parezca uno grande. Con la regla, madrid puede no devolver resultados cuando la biblioteca no contiene texto coincidente.
Combinar dos rankings que no hablan el mismo idioma
Una puntuación BM25 y una distancia coseno no son directamente comparables. Normalizarlas a una escala común hace que la combinación dependa del corpus, del idioma y de los umbrales usados para producir ese conjunto de resultados.
Combinamos en cambio las posiciones. Cada canal produce una lista ordenada; un documento en la posición r aporta 1 / (60 + r), mientras que un documento ausente de una lista no aporta nada de ese canal. Reciprocal Rank Fusion es simple, no requiere calibrar las puntuaciones y permite que un documento bien clasificado en ambas listas supere a uno respaldado por un solo método de recuperación.
Los límites de candidatos pueden ocultar coincidencias
Todo lo anterior trata de relevancia, pero los límites de candidatos determinan si los recursos relevantes son siquiera alcanzables.
Todo sistema de recuperación necesita un límite. En lugar de puntuar 200.000 documentos en cada pulsación de tecla, puede tomar los 1000 mejores candidatos léxicos y los 200 mejores candidatos vectoriales, y ordenar ese conjunto menor. Si la respuesta no informa del límite, la página y el paginador pueden parecer normales mientras faltan los recursos que quedan más allá del corte.
Por ejemplo, una colección contiene 400 recursos y 30 llevan el término de la consulta, pero la búsqueda devuelve cuatro. Los 1000 mejores candidatos se seleccionaron en toda la biblioteca antes de aplicar el filtro de la colección, así que los otros 26 quedaron fuera del conjunto de candidatos. Los recursos devueltos son relevantes; el problema es que la mayoría de las coincidencias elegibles nunca estuvieron disponibles para ordenarse.
El caso más general es el cap crowding (acaparamiento del tope): si 1953 documentos contienen todos los términos y solo se conservan 1000 candidatos, filas igual de relevantes pueden quedar excluidas por un criterio de desempate.
Nuestra solución es una segunda recuperación garantizada para las filas que deben seguir siendo alcanzables, como los miembros de la colección en la que se busca y los recursos cuyo título contiene literalmente el término. Estas filas entran después de las posiciones de escaneo ordenadas normalmente, y cada límite posterior las admite de forma explícita. La primera página mantiene el mismo orden, mientras que las filas adicionales siguen disponibles en las páginas posteriores y en el total.
La recuperación garantizada cambia con el tamaño del ámbito. Para una colección de cuarenta recursos, puntuamos los cuarenta directamente, lo que es completo por construcción y cuesta aproximadamente medio milisegundo por miembro. Hasta un par de miles de miembros, añadimos una comparación vectorial exacta sobre el ámbito en lugar de usar el índice aproximado. Hasta cincuenta mil, escaneamos la lista ordenada con más profundidad, mientras que los ámbitos mayores se solapan lo suficiente con el conjunto normal de candidatos como para que el trabajo extra sea menos útil.
Informar de si los resultados están completos
Los límites de candidatos llevan a una pregunta práctica: ¿puede el sistema decirle al usuario si ha mostrado todas las coincidencias?
Esto importa mucho más allá de la comodidad del usuario. «Selecciona los 1240 y aplica esta política de derechos» solo es seguro si 1240 es demostrablemente el conjunto completo. Una búsqueda que se trunca en silencio en 1000 convierte una operación en lote en un incidente de integridad de datos que nadie nota durante meses.
Por eso cada búsqueda de freedam devuelve un veredicto junto con sus resultados: completo, truncado o desconocido. Se calcula con columnas de conteo adicionales en la misma consulta, que miden cuántas filas produjo realmente cada fuente de candidatos frente al tope con el que operaba esa fuente. Si una fuente alcanzó su límite, el resultado está truncado, la interfaz lo dice y las operaciones en lote sobre él te avisan. Puntuar a cada miembro de una colección pequeña es completo por construcción. Un escaneo profundo es completo solo si terminó antes de su límite de filas. Una fuente nueva de candidatos es desconocido por defecto hasta que alguien demuestre lo contrario. Y un resultado obtenido mediante un mecanismo de respaldo, una corrección de errata o una expansión por prefijo nunca hereda el veredicto que obtuvo la consulta original.
Esto también cambió cómo revisamos la monitorización y las pruebas. Teníamos un monitor que se quedaba en silencio cuando su tarea moría, una prueba de desempate que seguía en verde después de que el desempate desapareciera de la consulta, y una suite de calidad cuyas advertencias no podían cambiar el código de salida. Para cada comprobación, ahora nos preguntamos qué resultado daría si el comportamiento se rompiera. Si un fallo produce la misma salida que un éxito, la comprobación necesita otra aserción observable.
Las otras formas de preguntar
El texto es una entrada. Otras tres importan específicamente para las imágenes, y seré breve porque cada una tiene su propio artículo.
Puedes buscar con una imagen para saber si ya estaba licenciada o para encontrar el resto de una sesión. Esta ruta usa hashes perceptuales y una búsqueda multi-índice para generar candidatos, y después un embedding visual para verificarlos. El artículo sobre casi duplicados trata los estilos de catálogo que debilitan el algoritmo estándar.
Puedes buscar a una persona. Los rostros tienen su propio detector y su propio espacio de embeddings en un sidecar que no envía imágenes fuera de la instalación. Un rostro no tiene nombre hasta que una persona lo confirma, así que el sistema agrupa candidatos y escribe en el documento de búsqueda solo los nombres confirmados. Los detalles están en el artículo sobre búsqueda de personas.
También puedes buscar con una frase. Nuestro asistente no ordena recursos; compila la frase en el mismo árbol de filtros que produce la interfaz de búsqueda avanzada, con una intención explícita como replace, refine, add o remove. Ese árbol se ejecuta por la ruta de recuperación normal con los mismos permisos y el mismo informe de exhaustividad, de modo que el usuario puede inspeccionar y corregir la interpretación. El artículo sobre búsqueda conversacional trata esa frontera y sus compromisos.
Cómo sabemos que algo de esto funciona
Evaluamos estas decisiones con sesenta consultas realistas y una verdad de referencia acordada, ejecutadas por la ruta de búsqueda de producción sobre una réplica de la biblioteca de un cliente de unos 23.000 recursos. El instrumento informa de aprobado/suspenso estricto, exhaustividad (recall) y posición recíproca, y tiene acceso de solo lectura, de modo que no puede cambiar ajustes ni reconstruir un índice. El artículo sobre medición explica el método y sus limitaciones.
La primera ejecución seria encontró quince fallos totales en una búsqueda que todos habían descrito como razonablemente buena. Más tarde atribuimos cinco regresiones de exhaustividad a un cambio de tokenización, pero la medición mostró que cuatro consultas tenían exactamente la misma exhaustividad y posición hasta el decimal quince. La causa real fue la longitud del documento, como en el caso de videos frente a fotos de arriba. El instrumento fue útil porque separó una explicación plausible del cambio que afectó al resultado.
De vuelta al vestido
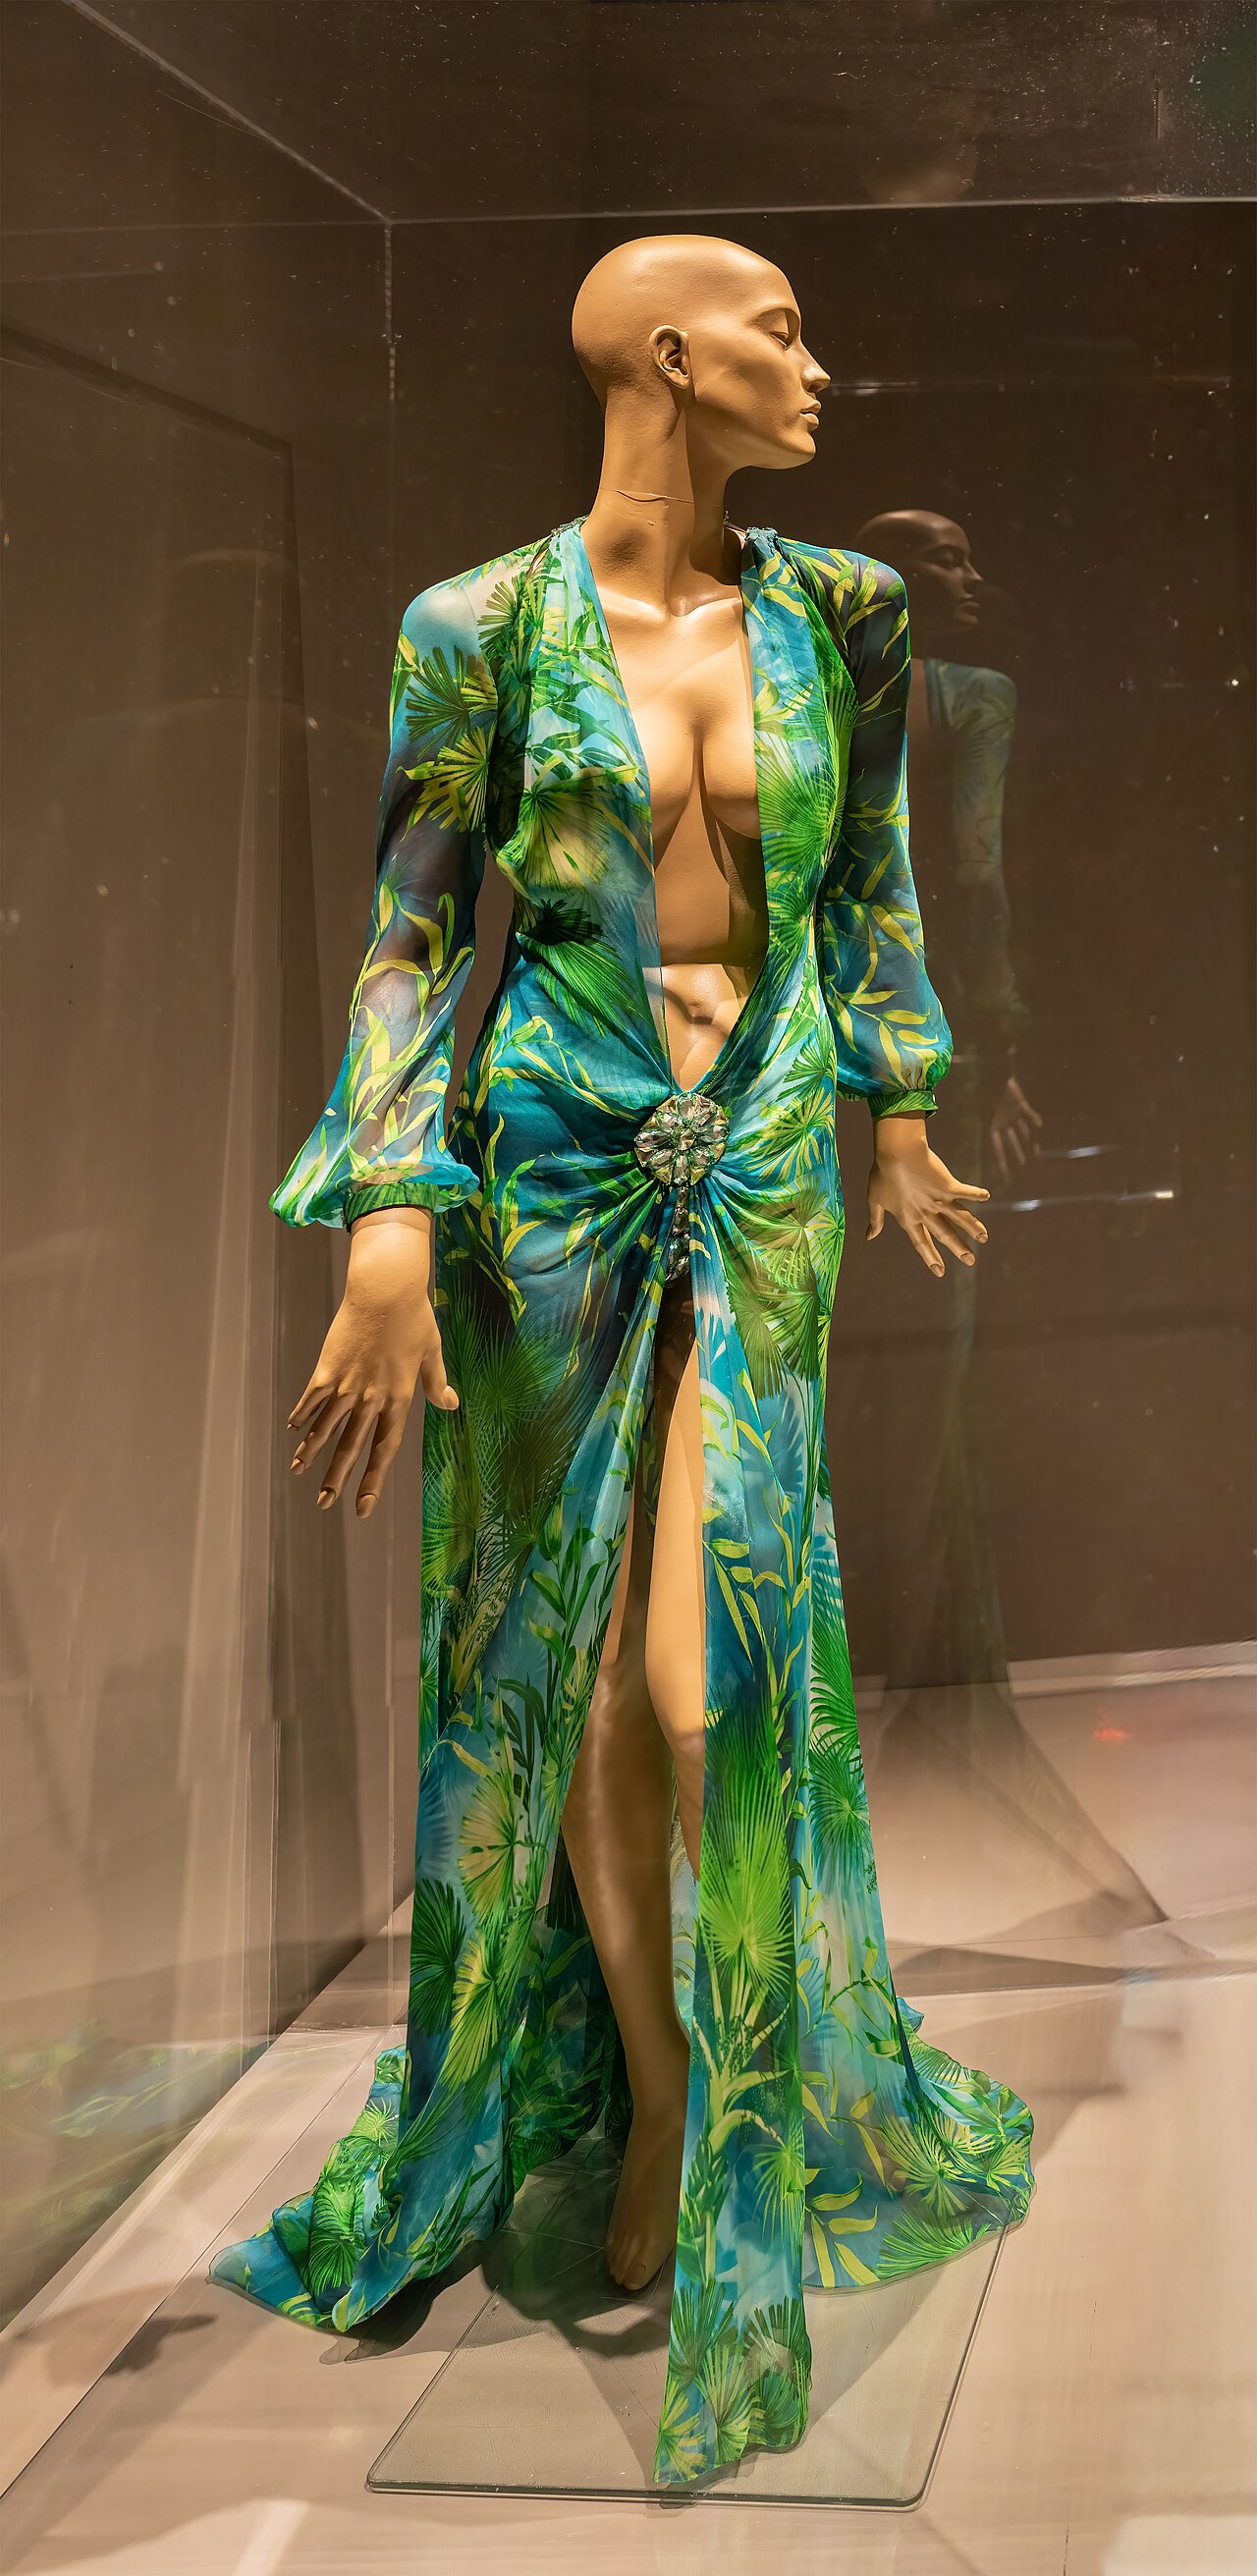
Google encontró el vestido en 2001 leyendo las palabras que rodeaban la imagen. Hoy nosotros encontramos la foto de un producto buscando en el texto ensamblado a su alrededor y en una representación vectorial producida a partir de la imagen y sus metadatos. Los modelos semánticos ayudan con las consultas descriptivas, mientras que el resto del sistema sigue teniendo que manejar identificadores, reglas de acceso, ámbitos, límites de candidatos y totales honestos.
Si estás empezando, dedica tiempo a la representación indexada, porque una consulta no puede recuperar términos que el tokenizador nunca emitió. Ejecuta juntas la recuperación léxica y la semántica, y fusiona sus posiciones en lugar de sus puntuaciones. Ajusta los umbrales vectoriales según la forma de la consulta, considera exigir respaldo léxico para las palabras sueltas y trata cada tope de candidatos como un posible problema de exhaustividad. Y, sobre todo, expón cuándo el sistema no puede demostrar que devolvió todas las coincidencias.
Si prefieres verlo antes que leerlo, hay una demo con una biblioteca de ejemplo. Lo interesante es buscar algo que nadie habría etiquetado y después buscar algo dentro de una carpeta y contar.