Ce qu’il faut vraiment pour construire une bonne recherche d’images
En février 2000, Jennifer Lopez a porté une robe Versace verte aux Grammys, et pendant quelques semaines, ce fut ce qu’on cherchait le plus sur Google. Google ne pouvait renvoyer que dix liens bleus, dont certains menaient à des pages susceptibles de contenir une photographie. Eric Schmidt a écrit plus tard que c’était la requête la plus populaire qu’ils aient jamais vue, et la raison pour laquelle ils avaient construit une recherche d’images. Google Images a été lancé en juillet 2001 et indexait environ 250 millions d’images.
J’aime cette histoire à cause de ce que les gens oublient de raconter : Google Images ne cherchait pas dans les pixels. Il indexait le nom de fichier, le texte alternatif, la légende et les mots proches d’une balise <img>, puis comparait la requête à ce texte. La robe était trouvable parce que des milliers de pages avaient écrit « Jennifer Lopez », « Versace » et « Grammys » à côté d’elle.
Vingt-cinq ans et plusieurs générations de vision par ordinateur plus tard, la recherche d’images commence toujours par créer quelque chose de cherchable à partir de l’image ou autour d’elle, ce qui explique bon nombre des problèmes pratiques qui suivent.
Je dirige freedam, un gestionnaire de médias numériques (digital asset manager) pour les photographies, les vidéos et les documents qu’une entreprise a besoin de retrouver. Nous avons passé plus de temps d’ingénierie sur la recherche que sur toute autre partie du produit : cet article rassemble donc ce que nous avons appris, pour ceux qui en construisent une ou qui veulent comprendre pourquoi la leur rate des résultats. Il existe aussi une version plus technique avec le SQL et les paramètres ; celle-ci s’en tient à la forme du problème.
Une image ne contient aucun mot
Une ligne d’une table de commandes contient un nom de client, un ticket de support contient un corps de message, et un PDF peut avoir une couche de texte. Un JPEG a trois canaux de couleur et quelques données EXIF, mais aucun terme qu’une requête texte puisse faire correspondre directement.
Une recherche d’images a donc besoin d’un substitut cherchable pour l’image. En pratique, ces substituts se répartissent en quatre grands groupes, et chacun couvre des requêtes que les autres ne couvrent pas.
Des mots saisis par quelqu’un. Un nom de fichier, un titre, une légende ou le texte autour d’une image. C’est sur cela que Google Images a démarré, et sur cela qu’AltaVista Photo Finder avait démarré trois ans plus tôt. C’est peu coûteux et souvent efficace, parce que les gens sont doués pour nommer les choses, mais cela n’aide en rien quand un dossier ne contient que des fichiers nommés DSC_0001 à DSC_4817.
Des mots issus d’un vocabulaire. Les tags, les catégories et les taxonomies sont précis et filtrables, ce qui explique que les agences de photos et les photothèques d’entreprise s’appuient dessus. Ils sont aussi coûteux à maintenir, et le vocabulaire tend à s’éloigner du langage que les gens emploient pour chercher.
Des mots écrits par une machine. Cela comprend l’OCR de l’image, les légendes produites par un modèle de vision et les transcriptions de vidéos. L’ESP Game de Luis von Ahn utilisait une version humaine en 2004 : deux inconnus voyaient la même image, marquaient des points lorsqu’ils saisissaient le même mot, et leur accord devenait une étiquette. Google l’a sous licence sous le nom de Google Image Labeler en 2006 et l’a exploité pendant cinq ans. Les modèles peuvent aujourd’hui produire ces étiquettes à grande échelle, même si le résultat est bruité et dépourvu de contexte métier : un modèle peut reconnaître une basket sans savoir que c’est le SKU 4471-RD.
Aucun mot. Une image peut être représentée par des nombres et comparée à d’autres représentations numériques. QBIC d’IBM le faisait en 1995 en laissant les gens esquisser une disposition de couleurs. TinEye en 2008 et la recherche par image de Google en 2011 ont rendu familière la forme inverse : fournir une image et retrouver ses copies. CLIP a ensuite placé le texte et les images dans le même espace numérique : une requête comme a dog on a skateboard pouvait ainsi trouver une image que personne n’avait taguée avec ces mots. C’est la base de la plupart des récentes démonstrations de « recherche IA ».
Rien dans cette liste n’a remplacé ce qui précédait. Google Images utilise toujours le texte environnant et les agences de photos paient toujours des gens pour taguer les images, parce que chaque représentation répond à des questions que les autres ne savent pas traiter. Notre première erreur a été de traiter l’une d’elles comme la réponse principale au lieu de les combiner.
Ce que la recherche poursuivait pendant ce temps
La recherche menée parallèlement à ces produits a consacré une trentaine d’années à une question : comment réduire l’écart entre les caractéristiques visuelles et le sens exprimé par une requête. Les modèles récents ont réalisé des progrès substantiels, même si le résultat est plus étroit que ne le laissent croire de nombreuses démonstrations.
L’expression « content-based image retrieval » (recherche d’images par le contenu) a été forgée en 1992 par Toshikazu Kato, au Electrotechnical Laboratory japonais, pour désigner l’idée qu’on pourrait chercher des images d’après ce qu’elles contiennent plutôt que d’après ce que quelqu’un a écrit à leur sujet. QBIC d’IBM a été le premier système sérieux à l’essayer. Il savait comparer des histogrammes de couleurs, des textures et des formes, et on l’interrogeait par une esquisse. Le Photo Finder d’AltaVista, en 1998, construit avec une société nommée Virage, a bel et bien proposé au public un bouton « visuellement similaire », et le public, dans son immense majorité, a continué de saisir des mots.
La raison en a été nommée en 2000, dans un article de synthèse de Smeulders et ses collègues que tous les chercheurs du domaine citent depuis : le fossé sémantique (semantic gap). L’écart entre ce qu’un ordinateur peut extraire des pixels (cette région est verdâtre, ce bord est vertical) et ce qu’une personne veut dire par une requête (une robe, une célébrité, une cérémonie de remise de prix). Les histogrammes de couleurs se trouvent d’un côté de cet écart. Toutes les requêtes que quelqu’un saisit réellement se trouvent de l’autre. Pendant les vingt années suivantes, le programme de recherche a été, pour l’essentiel : « combler l’écart ».
Il s’est comblé par étapes, et chaque étape a fini dans un produit. Les caractéristiques locales (SIFT, 1999) et l’astuce « Video Google » de 2003, qui traitait des fragments visuels comme des mots et les indexait comme du texte, sont les ancêtres directs de TinEye et de la recherche inversée d’images de Google : une correspondance d’images identiques à l’échelle du web, ce qui est un problème différent et plus simple que celui du sens. ImageNet, en 2009, a rendu disponible un million d’images étiquetées, et AlexNet, en 2012, a montré qu’un réseau de neurones entraîné dessus produisait des caractéristiques qui battaient tous les descripteurs conçus à la main. Puis, en 2013, un article de Google appelé DeViSE a fait quelque chose qui paraît évident aujourd’hui et qui paraissait étrange alors : il a entraîné les caractéristiques des images à atterrir près des vecteurs de mots de leurs étiquettes, de sorte qu’une image d’une chose et le nom de cette chose se trouvaient proches dans un même espace, et qu’un modèle pouvait reconnaître des catégories sur lesquelles il n’avait jamais été entraîné. CLIP, en 2021, a été cette idée portée à 400 millions de paires image-texte collectées sur le web. L’écart qui avait été le problème central du domaine depuis 1992 était, pour les requêtes descriptives, en grande partie comblé.
Le qualificatif important est descriptives. CLIP peut trouver a dog on a skateboard, mais il ne sait pas trouver de façon fiable SS26-HERO-03, comprendre que la recherche en cours est limitée à une collection, ni signaler qu’une limite de candidats a exclu 953 résultats. Ce sont des problèmes de produit et de recherche, traités par un autre ensemble d’outils : BM25 pour le classement par mots-clés, la fusion de rangs réciproques (reciprocal rank fusion) pour combiner des listes de résultats, et HNSW pour la recherche rapide de plus proches voisins sur des vecteurs. La recherche sémantique est utile, mais elle reste un composant du moteur de recherche.
Ce que les gens attendent vraiment
Avant l’architecture, je veux consacrer un moment aux utilisateurs, parce que leurs attentes sont à l’origine de la plupart des contraintes de conception, et qu’elles ne sont pas ce qu’un ingénieur de recherche choisirait.
La plupart des gens ont appris l’interaction avec Google Images, où les résultats arrivent vite, où la grille se termine rarement et où il n’existe pas de bonne réponse unique à sunset. Si l’une des premières images est utile, la recherche a fait son travail.
La photothèque d’une entreprise est un animal différent, et le modèle mental de Google y est activement nuisible, de façons que j’ai mis des années à voir.
Dans une photothèque d’entreprise, la réponse est généralement plus précise : le coucher de soleil du shooting de Lisbonne, avec le pont, utilisé dans le rapport annuel de l’an dernier. Il peut y avoir un seul résultat correct ou douze : une grille de 400 couchers de soleil plausibles n’est donc pas particulièrement utile.
De nombreuses requêtes de photothèque ne sont pas du tout des descriptions. Les logs contiennent 4471-RD, SS26-HERO-03, des numéros de facture et des noms de modèles, courants dans un DAM et mal adaptés à la recherche sémantique, parce que les plus proches voisins d’un SKU sont généralement d’autres SKU.
Les gens cherchent aussi à l’intérieur d’un dossier, d’une collection ou d’une campagne. « Trouve les images principales de ce shooting » est une demande courante, et les limites de candidats peuvent rendre ce type de recherche incomplet sans que la page de résultats paraisse défaillante.
« Aucun résultat » peut aussi être utile. Si personne n’a photographié le nouveau magasin de Madrid, l’utilisateur doit peut-être commander ce travail, alors que remplir la grille de photographies de Barcelone et de Séville ne fait que masquer cette information.
Enfin, les gens agissent sur des ensembles de résultats entiers : « Sélectionne les 1 240 résultats et applique cette date d’expiration de licence. » Ce n’est sûr que si 1 240 est vraiment l’ensemble complet.
On juge généralement une recherche à ses premiers résultats : les correspondances manquantes sont donc difficiles à remarquer. Une requête peut perdre les deux tiers de ses médias pertinents et renvoyer tout de même une page plausible en quatre-vingt-dix millisecondes. Dans une photothèque que tout le monde, nous compris, jugeait raisonnablement bonne, la mesure a révélé des échecs nets sur quinze requêtes réalistes sur soixante, dont aucun n’avait été signalé.
Pour une photothèque d’entreprise, une bonne recherche d’images doit donc trouver des médias précis, gérer les identifiants autant que les descriptions, fonctionner à l’intérieur d’un périmètre, renvoyer un résultat vide honnête et signaler si des limites de candidats ont pu exclure des correspondances. Le reste de cet article explique comment nous avons abordé ces exigences.
L’indexation fixe la limite
Nous avons d’abord passé trop de temps sur le classement, parce que c’est la partie visible de la recherche, mais beaucoup de nos problèmes de rappel (recall) commençaient à l’indexation. Une requête ne peut pas récupérer un terme qui n’a jamais été placé dans la représentation cherchable du média.
Nous compilons donc un document de recherche stocké pour chaque média et chaque langue, reconstruit quand le média change. Il inclut le titre, le nom de fichier, la description, le créateur, le copyright, le lieu, les mots-clés, les tags et légendes générés, l’OCR, les métadonnées personnalisées, les noms de collections, les noms de personnes confirmées et les sous-titres de vidéos. Les termes de vocabulaire contrôlé incluent aussi leurs ancêtres : un média tagué espresso machine peut ainsi être trouvé via small appliances ou kitchen sans que l’utilisateur connaisse la taxonomie.
Deux aspects de ce document se sont révélés bien plus importants que je ne le pensais.
Le premier est la pondération. Un titre doit compter plus qu’une ligne d’OCR, et comme un index de mots-clés n’a aucune notion de champs, nous représentons ce poids en répétant le texte important dans le document. Cela fonctionne, mais modifie aussi la longueur du document. Comme le score par mots-clés se normalise selon la longueur, la répétition peut favoriser les documents plus courts en cas d’égalité. Dans une requête sur un nom de lieu, onze vidéos de produits ont devancé les photographies de produits : les documents des vidéos faisaient de 155 à 493 caractères, alors que les documents plus riches des images en faisaient de 746 à 1 280.
Le second est la tokenisation, qui décide où un terme se termine et où le suivant commence. Nous avons trouvé un petit exemple utile avec des libellés de compatibilité comme Galaxy A52/A52S : PostgreSQL traitait la valeur comme un seul token en forme de chemin, de sorte qu’une requête contenant a52 manquait des médias qui portaient visiblement ce libellé. Normaliser les séparateurs avant l’indexation a réglé le cas. La leçon plus générale est simplement d’inspecter les termes produits par l’analyseur quand le texte est présent mais que le rappel est étonnamment faible, car reconstruire les mêmes tokens ne changera pas le résultat.
Deux façons de chercher, une base de données
Une fois le document constitué, il existe deux façons utiles de le chercher, et elles excellent dans des domaines opposés.
La première est la recherche par mots-clés avec BM25. Le nom n’est pas très parlant (il signifie « Best Match », et 25 est le numéro de version qui s’est imposé), mais l’idée est simple : un document obtient un meilleur score quand un terme de la requête y apparaît plus souvent, quand le terme est rare dans la photothèque et quand le document est court. La formule date de 1994 et reste efficace pour des termes exacts comme 4471-RD. Sa faiblesse est le vocabulaire : quand le photographe a écrit autumn et que le marketeur cherche fall, il peut n’y avoir aucun terme commun à classer.
La seconde est l’approche de type CLIP : transformer le document et l’image en points dans un espace de 768 dimensions, placer la requête dans le même espace et renvoyer les points proches. Cela peut trouver team celebrating outdoors quand personne n’a employé ces mots, mais un index vectoriel renvoie toujours k voisins, y compris quand aucun n’est une bonne correspondance. Un seuil de distance fait donc partie de la conception de la recherche, et n’est pas un simple réglage facultatif du classement.
Nous exécutons les deux dans PostgreSQL, sur la même instance que les médias : BM25 via pg_textsearch, et les vecteurs via pgvector avec un index HNSW. Cela évite un service de recherche séparé et son pipeline de synchronisation.
Le compromis est simple. Un nouveau média peut devenir cherchable dans la transaction qui l’insère, tandis que les permissions, les embargos et les droits d’usage restent de simples clauses WHERE au lieu d’un second modèle d’autorisation. Les installations auto-hébergées ont aussi un service avec état de moins à exploiter. En contrepartie, la forme de la requête compte énormément : dans un cas, référencer deux fois la même sous-requête a transformé une requête de 6 ms en une requête de 7,3 secondes, parce que le planificateur avait perdu la borne de lignes nécessaire à un parcours d’index top-k. Une grande partie du travail consiste donc à vérifier les plans et à garder visibles pour PostgreSQL les bornes voulues.
Les embeddings viennent de modèles nomic de texte et de vision entraînés à partager un espace, exécutés dans un sidecar auto-hébergé pour que les images des clients ne quittent pas l’installation. Deux détails opérationnels ont compté. D’abord, les modèles utilisent des préfixes de tâche : les documents sont encodés avec search_document et les requêtes avec search_query, ces entrées doivent donc être couvertes par des tests, car un préfixe incorrect dégrade la qualité sans produire d’erreur. Ensuite, nous mettons brièvement en cache les échecs d’encodage des requêtes, ce qui permet à la recherche de se rabattre sur la recherche lexicale au lieu de contacter à chaque frappe un sidecar indisponible.
À partir de quelle distance est-ce assez proche ?
La voie vectorielle a besoin d’un seuil au-delà duquel un voisin n’est plus considéré comme une correspondance. Nous attendions un seul seuil, mais la valeur utile variait avec la longueur de la requête et n’était pas monotone.
| Requête | Distance cosinus max |
|---|---|
| 1 mot | 0,35 |
| 2 mots | 0,42 |
| 3 à 5 mots | 0,45 |
| 6 à 10 mots | 0,48 |
| plus de 10 mots | 0,40 |
Les deux extrémités sont strictes, pour des raisons opposées. Un mot isolé comme chair a un voisinage sémantique gigantesque : avec un seuil lâche, il correspond à toutes les photographies d’intérieur de la photothèque, remplit la page et a l’air fiable tout en étant inutile. Une requête très longue, qui en pratique est quelqu’un qui colle un titre de produit entier, produit un embedding vague, moyenné, qui se situe faiblement près de tout ; relâchez le seuil à cet endroit et vous récupérez tout le corpus, par ordre de confiance. La bande médiane, où la requête est assez précise pour signifier quelque chose et assez courte pour continuer à le signifier, est celle où la recherche sémantique justifie sa place.
Les requêtes d’un seul mot reçoivent une règle supplémentaire : un résultat doit aussi avoir une correspondance lexicale. Sans elle, les termes de niche tendent à remplir la page d’images sémantiquement voisines, ce qui fait paraître un résultat vide comme un résultat abondant. Avec cette règle, madrid peut ne renvoyer aucun résultat quand la photothèque ne contient aucun texte correspondant.
Combiner deux classements qui ne parlent pas la même langue
Un score BM25 et une distance cosinus ne sont pas directement comparables. Les normaliser sur une échelle commune fait dépendre la combinaison du corpus, de la langue et des seuils utilisés pour produire cet ensemble de résultats.
Nous combinons donc des rangs. Chaque voie produit une liste ordonnée ; un document à la position r contribue 1 / (60 + r), tandis qu’un document absent d’une liste ne contribue rien de cette voie. La Reciprocal Rank Fusion est simple, ne demande aucune calibration des scores, et permet à un document bien classé dans les deux listes de devancer un document soutenu par une seule méthode de recherche.
Les limites de candidats peuvent masquer des correspondances
Tout ce qui précède concerne la pertinence, mais les limites de candidats déterminent si les médias pertinents sont atteignables.
Tout système de recherche a besoin d’une borne. Plutôt que de scorer 200 000 documents à chaque frappe, il peut retenir les 1 000 premiers candidats lexicaux et les 200 premiers candidats vectoriels, puis classer cet ensemble réduit. Si la réponse n’indique pas la borne, la page et le paginateur peuvent paraître normaux alors que des médias situés au-delà de la coupe sont absents.
Par exemple, une collection contient 400 médias et 30 portent le terme recherché, mais la recherche en renvoie quatre. Les 1 000 premiers candidats ont été sélectionnés sur toute la photothèque avant l’application du filtre de collection : les 26 autres se sont donc retrouvés hors de l’ensemble de candidats. Les médias renvoyés sont pertinents ; le problème est que la plupart des correspondances éligibles n’ont jamais été disponibles pour le classement.
Le cas plus général est la saturation du plafond (cap crowding) : si 1 953 documents contiennent tous les termes et que seuls 1 000 candidats sont conservés, des lignes tout aussi pertinentes peuvent être exclues par un départage.
Notre correctif est une seconde récupération garantie pour les lignes qui doivent rester atteignables, comme les membres de la collection dans laquelle on cherche et les médias dont le titre contient littéralement le terme. Ces lignes entrent après les positions du scan classé normalement, et chaque limite en aval les admet explicitement. La première page garde le même ordre, tandis que les lignes supplémentaires restent disponibles dans les pages suivantes et dans le total.
La récupération garantie varie avec la taille du périmètre. Pour une collection de quarante médias, nous scorons les quarante directement, ce qui est complet par construction et coûte environ une demi-milliseconde par membre. Jusqu’à quelques milliers de membres, nous ajoutons une comparaison vectorielle exacte sur le périmètre au lieu d’utiliser l’index approximatif. Jusqu’à cinquante mille, nous parcourons la liste classée plus en profondeur, tandis que les périmètres plus grands recoupent assez le pool de candidats normal pour que le travail supplémentaire soit moins utile.
Indiquer si les résultats sont complets
Les limites de candidats conduisent à une question pratique : le système peut-il dire à l’utilisateur s’il a montré toutes les correspondances ?
Cela compte bien au-delà du confort de l’utilisateur. « Sélectionne les 1 240 et applique cette politique de droits » n’est sûr que si 1 240 est démontrablement l’ensemble complet. Une recherche qui tronque silencieusement à 1 000 transforme une opération en masse en incident d’intégrité des données dont personne ne s’aperçoit pendant des mois.
Chaque recherche freedam renvoie donc un verdict avec ses résultats : complete (complet), truncated (tronqué) ou unknown (inconnu). Il est calculé par des colonnes de comptage supplémentaires dans la même requête, qui mesurent combien de lignes chaque source de candidats a réellement produites par rapport au plafond sous lequel cette source fonctionnait. Si une source a atteint sa borne, le résultat est tronqué, l’interface le dit, et les opérations en masse sur ce résultat avertissent. Scorer tous les membres d’une petite collection est complet par construction. Un scan profond n’est complet que s’il s’est terminé avant sa borne de lignes. Une nouvelle source de candidats vaut unknown par défaut tant que personne n’a prouvé le contraire. Et un résultat obtenu par un repli, une correction de faute ou une expansion de préfixe n’hérite jamais du verdict qu’avait obtenu la requête d’origine.
Cela a aussi changé notre façon de passer en revue la supervision et les tests. Nous avions un monitor qui restait silencieux après la mort de sa tâche, un test de départage qui restait vert après la disparition du départage dans la requête, et une suite de qualité dont les avertissements ne pouvaient pas modifier le code de sortie. Pour chaque contrôle, nous nous demandons désormais ce que serait sa sortie si le comportement était cassé. Si l’échec produit la même sortie que le succès, le contrôle a besoin d’une autre assertion observable.
Les autres façons de demander
Le texte est une entrée. Trois autres comptent spécifiquement pour les images, et je serai bref, car chacune a son propre article.
Vous pouvez chercher avec une image pour savoir si elle a déjà été sous licence, ou pour retrouver le reste d’un shooting. Ce chemin utilise des hashs perceptuels et une recherche multi-index pour générer des candidats, puis un embedding visuel pour les vérifier. L’article sur les quasi-doublons traite des styles de catalogue qui affaiblissent l’algorithme standard.
Vous pouvez chercher une personne. Les visages ont leur propre détecteur et leur propre espace d’embeddings, dans un sidecar qui n’envoie aucune image hors de l’installation. Un visage n’a pas de nom tant qu’une personne ne l’a pas confirmé : le système regroupe donc des candidats et n’écrit que des noms confirmés dans le document de recherche. Les détails se trouvent dans l’article sur la recherche de personnes.
Vous pouvez aussi chercher avec une phrase. Notre assistant ne classe pas les médias ; il compile la phrase en l’arbre de filtres que produit l’interface de recherche avancée, avec un intent explicite tel que replace, refine, add ou remove. Cet arbre passe par le chemin de recherche normal, sous les mêmes permissions et avec le même compte rendu d’exhaustivité : l’utilisateur peut donc examiner et corriger l’interprétation. L’article sur la recherche conversationnelle traite de cette frontière et de ses compromis.
Comment nous savons que tout cela fonctionne
Nous évaluons ces décisions avec soixante requêtes réalistes et une vérité terrain convenue, exécutées via le chemin de recherche de production sur une réplique de la photothèque d’un client d’environ 23 000 médias. L’instrument rapporte la réussite ou l’échec net, le rappel et le rang réciproque, et il n’a qu’un accès en lecture seule : il ne peut donc ni modifier de réglages ni reconstruire un index. L’article sur la mesure explique la méthode et ses limites.
La première exécution sérieuse a révélé quinze échecs nets dans une recherche que tout le monde décrivait comme raisonnablement bonne. Plus tard, nous avons attribué cinq régressions de rappel à un changement de tokenisation, mais la mesure a montré que quatre requêtes avaient un rappel et un rang identiques à quinze décimales près. La vraie cause était la longueur des documents, comme dans le cas vidéos contre photos plus haut. L’instrument a été utile parce qu’il a séparé une explication plausible du changement qui avait réellement affecté le résultat.
Retour à la robe
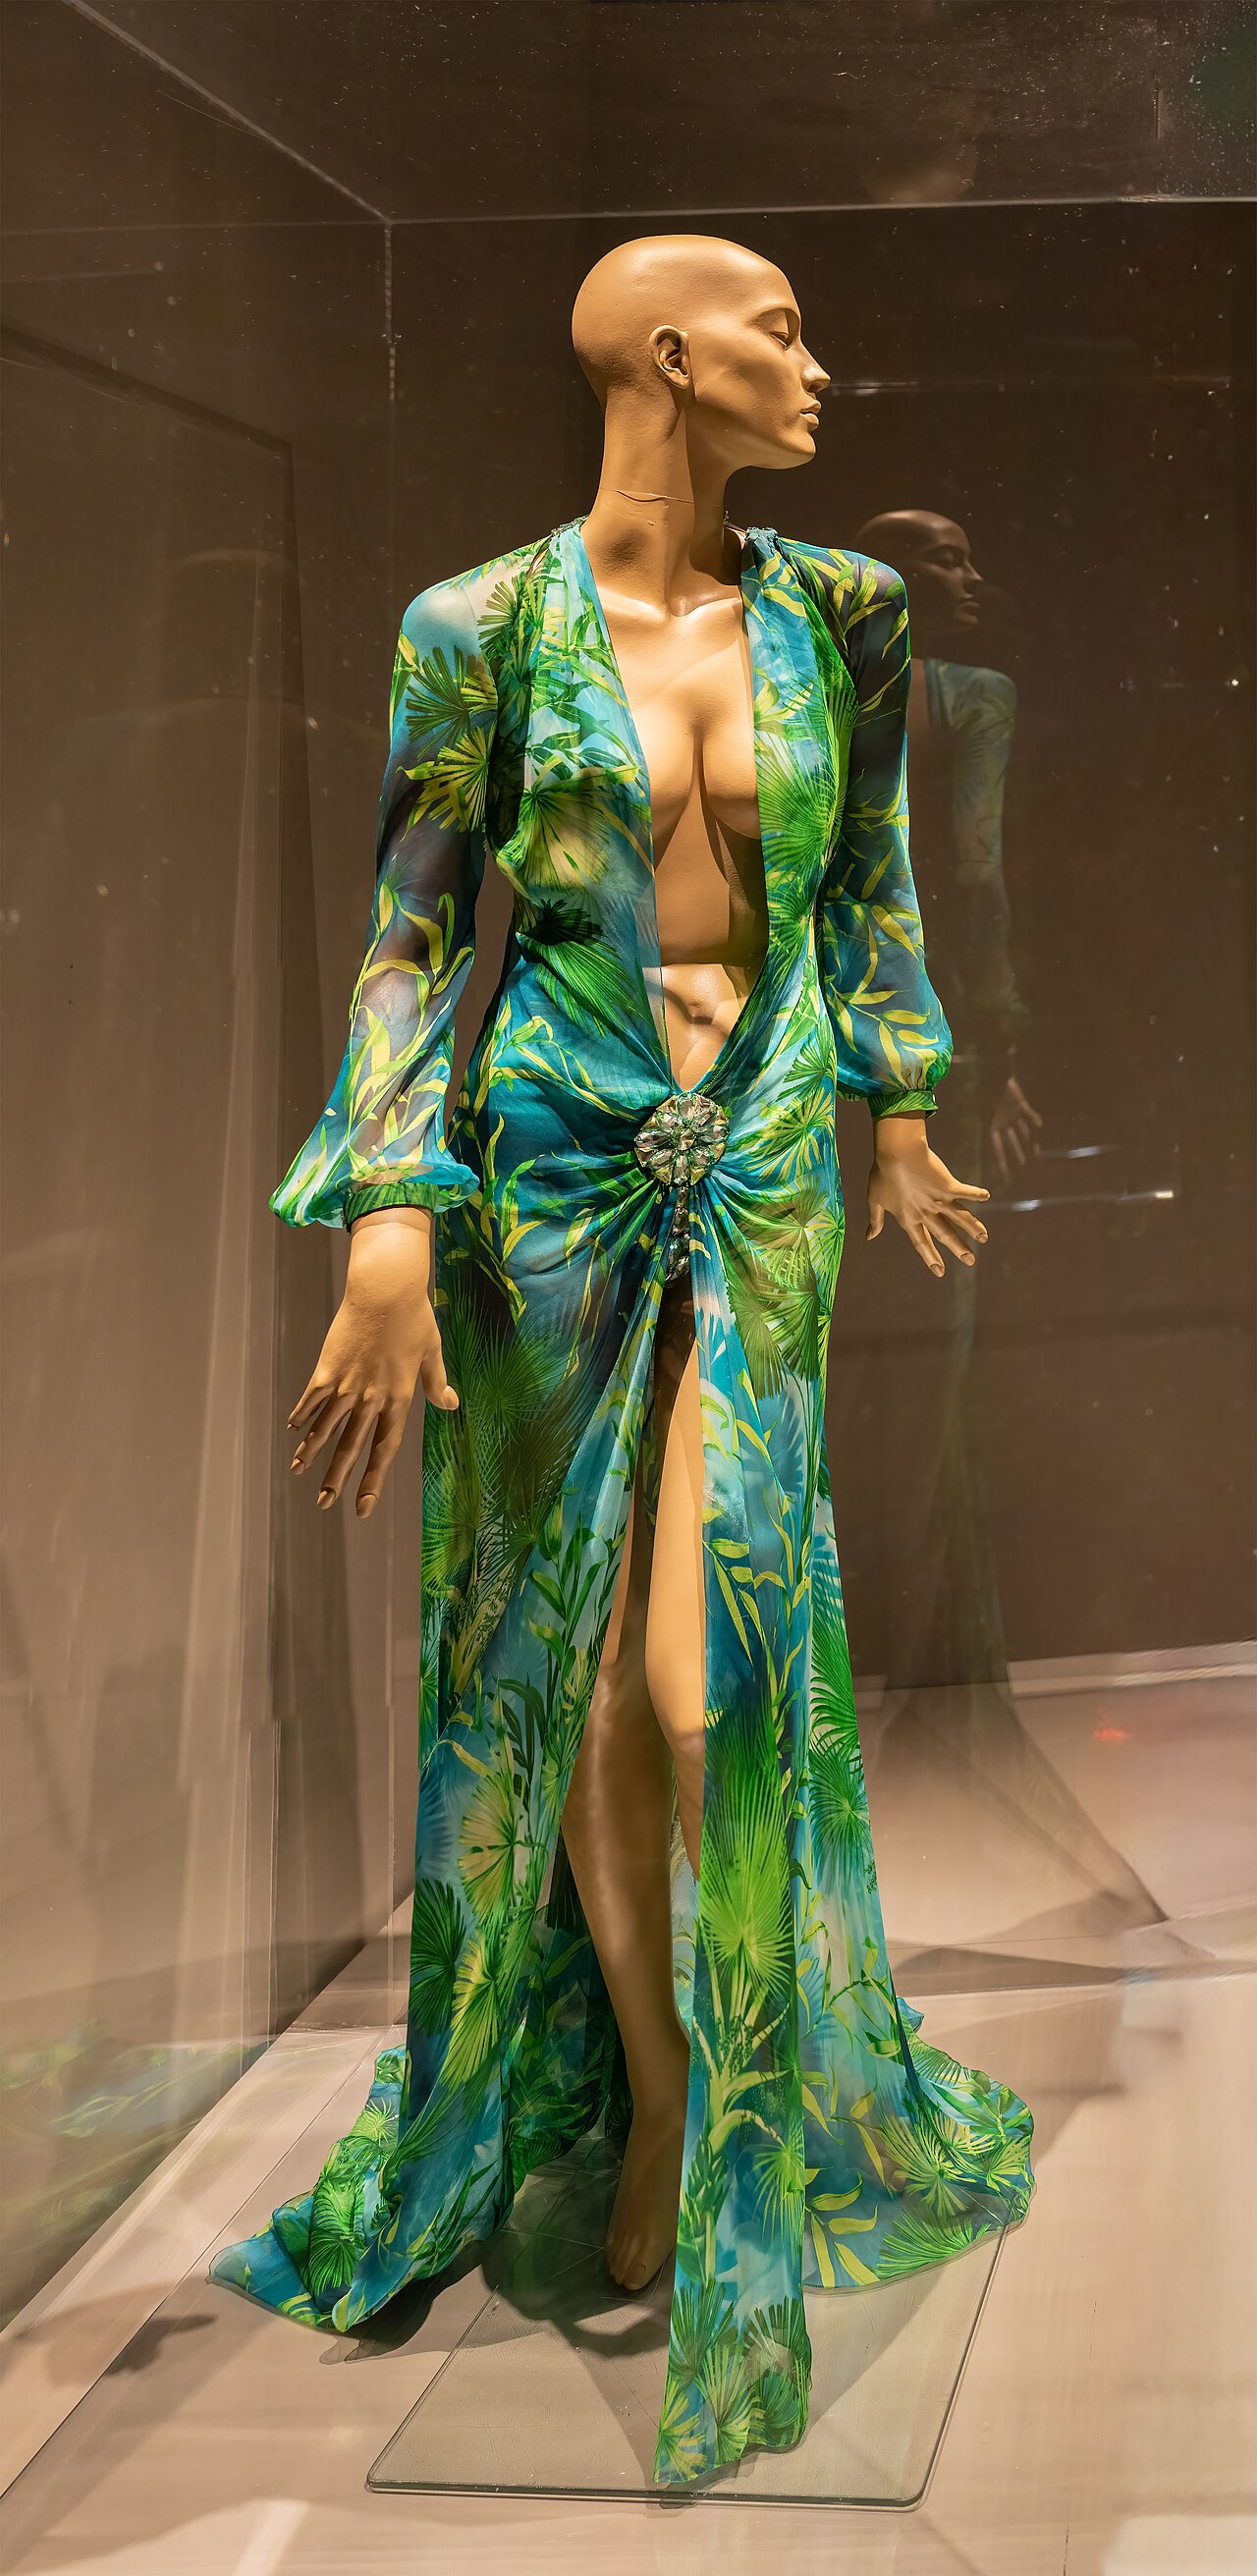
Google a trouvé la robe en 2001 en lisant les mots autour de l’image. Aujourd’hui, nous trouvons une photo de produit en cherchant le texte assemblé autour d’elle et une représentation vectorielle produite à partir de l’image et de ses métadonnées. Les modèles sémantiques aident pour les requêtes descriptives, mais le reste du système doit encore gérer les identifiants, les règles d’accès, les périmètres, les limites de candidats et des totaux honnêtes.
Si vous débutez, consacrez du temps à la représentation indexée, car une requête ne peut pas retrouver des termes que le tokenizer n’a jamais émis. Exécutez ensemble la recherche lexicale et la recherche sémantique, et fusionnez leurs rangs plutôt que leurs scores. Réglez les seuils vectoriels selon la forme de la requête, envisagez d’exiger un appui lexical pour les mots isolés, et traitez chaque plafond de candidats comme un problème possible d’exhaustivité. Surtout, signalez quand le système ne peut pas prouver qu’il a renvoyé toutes les correspondances.
Si vous préférez voir plutôt que lire, il existe une démo avec une photothèque préremplie. La chose intéressante à faire est de chercher quelque chose que personne n’aurait tagué, puis de chercher quelque chose à l’intérieur d’un dossier, et de compter.