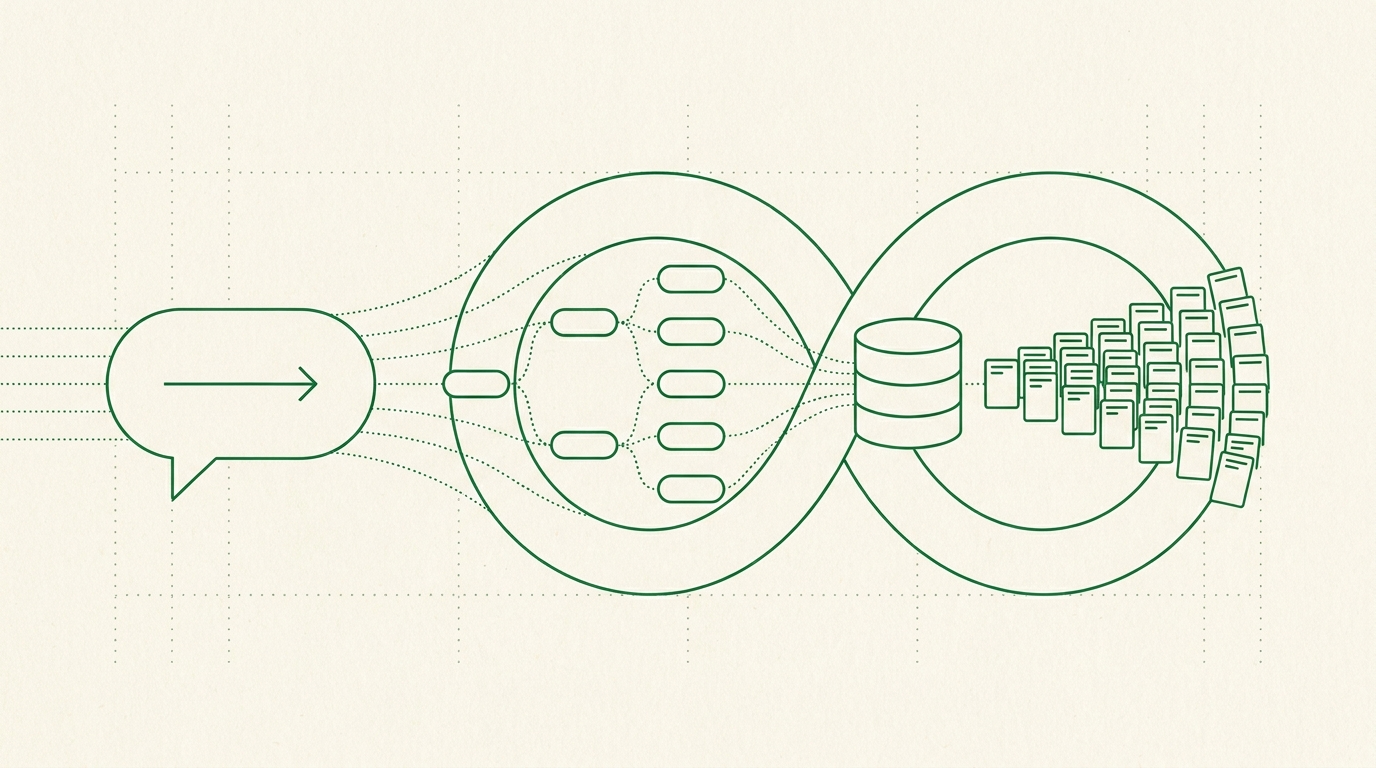
El chat que nunca ve tu biblioteca
Una primera versión habitual de la búsqueda conversacional envía una frase y una muestra de recursos a un modelo de lenguaje, y le pide que elija los relevantes. Esto puede funcionar en una demo pequeña, pero no escala con la biblioteca y no puede tener en cuenta los recursos que quedan fuera de la ventana de contexto.
freedam, en cambio, usa el modelo solo para convertir una frase en un árbol de filtros; el modelo no recibe recursos ni los ordena. El árbol lo ejecuta el motor de recuperación descrito en el artículo de arquitectura, con BM25 y pgvector en PostgreSQL, bajo las mismas reglas de acceso y la misma lógica de conteo de resultados que la galería.
Este artículo explica los beneficios y los costos de esa frontera, e incluye el estado que sobrevive al truncamiento del historial, las respuestas que se generan antes de que se ejecute la recuperación y tres limitaciones actuales en la fusión del árbol de reglas.
Separar la interpretación de la recuperación
«Buscar con IA» combina interpretación y recuperación, pero las dos tareas tienen perfiles de costo distintos.
Interpretar una consulta tiene un costo aproximadamente fijo. «Algo tranquilo para la cabecera del boletín, en horizontal, que no sean los que usamos la primavera pasada» contiene un estado de ánimo, una relación de aspecto y una exclusión temporal, y extraer esas restricciones cuesta una llamada al modelo, tanto si la biblioteca contiene cuatrocientos recursos como cuatrocientos mil.
Recuperar del corpus es una tarea de alto volumen cuyo costo crece con la biblioteca, así que corresponde a consultas indexadas en la base de datos y no al contexto de un modelo.
La frontera también afecta a cómo se comunican los resultados. Un motor de recuperación puede decir que encontró 1247 coincidencias, o que un tope de candidatos hace que el total sea solo una cota inferior, usando el informe de exhaustividad que comparte el resto de la pila de búsqueda. Un modelo que solo recibe una página de recursos no puede distinguir un corpus vacío de una muestra incompleta, lo que hace que su respuesta no sirva para operaciones en lote.
Por eso dejamos que el modelo interprete el lenguaje y que PostgreSQL recupere de la biblioteca.
Qué produce el modelo
Cada turno produce exactamente un objeto JSON, con tres claves.
{
    "intent": "refine",
    "rule_group": {
        "type": "group",
        "operator": "and",
        "rules": [
            {
                "field": "full_text_search",
                "operator": "hybrid_search",
                "value": "sunset"
            },
            {
                "field": "asset.aspect_ratio_orientation",
                "operator": "equals",
                "value": "landscape"
            }
        ]
    },
    "explanation": "Narrowing to landscape shots with sunset colours."
}
rule_group es el mismo árbol de reglas que construye el editor de filtros avanzados de la galería, el que serializan las búsquedas guardadas y el que se compila a SQL. Reutilizar esa estructura evita un lenguaje de consulta propio del chat y mantiene la búsqueda conversacional en la misma ruta de ranking y recuperación que el resto del producto.
intent indica qué hacer con el árbol en relación con la conversación hasta ese momento. explanation es el único lenguaje natural que ve el usuario, y el prompt del sistema lo limita a una frase corta en el idioma de la interfaz del usuario. Eso importa más de lo que parece y es donde reaparece el trabajo multilingüe: los nombres de campo, los nombres de operador y los valores de intención se quedan en inglés porque son identificadores, mientras que la frase que los rodea se genera en francés o en chino simplificado.
Usamos temperatura 0,1, el formato de respuesta json_object y, cuando está disponible, la variante de enrutamiento Exacto de OpenRouter para proveedores verificados en salida estructurada. El modelo por defecto es openai/gpt-oss-120b, un modelo de pesos abiertos de tamaño medio, porque la tarea consiste en traducir a un esquema que se valida más adelante.
Generar el prompt a partir del esquema del tenant
En un tenant de desarrollo con 22.944 recursos y 48 definiciones de metadatos, el prompt del sistema mide 36.790 caracteres en 646 líneas. De ellos, 16.646 caracteres, aproximadamente el 45 %, se generan a partir de la base de datos del tenant para la solicitud en curso.
La parte fija, de 19.840 caracteres, es el esqueleto de instrucciones: el esquema de salida, las seis intenciones, el orden de prioridad de los métodos de búsqueda, los ejemplos resueltos y una lista de cosas que no hay que hacer que fue creciendo de una en una al observar fallos reales. La parte generada es un catálogo del vocabulario de negocio del tenant, armado por clase de recurso, y es lo que hace que el mismo prompt se comporte de forma completamente distinta para un minorista de muebles y para un proveedor de piezas de aviación.
Tres decisiones de la sección generada sirven más allá de esta implementación.
Muestrea los valores, no solo el esquema. Para cada campo de texto, el prompt incluye los veinticinco valores más frecuentes que existen realmente en la biblioteca. Para cada campo numérico o de fecha, el mínimo y el máximo observados. Para cada campo de vocabulario, hasta cincuenta etiquetas de términos reales. Un modelo al que se le dice que existe un campo llamado product_designer tenderá a adivinarlo; un modelo al que se le muestra que sus valores se parecen a Henning Koppel y Louise Adelborg asignará correctamente un apellido a ese campo al primer intento.
Nunca hagas que el modelo adivine un identificador. Los términos de vocabulario son claves foráneas, y un modelo al que se le pide un ID de término inventará uno que sea sintácticamente válido. Por eso el conjunto de operadores incluye vocab_text_equals y vocab_text_in, que reciben texto humano, y la resolución a un ID ocurre después, en el compilador, usando la similitud de trigramas de PostgreSQL con un umbral de 0,45 y probando primero una coincidencia exacta sin distinguir mayúsculas. El modelo aporta aquello en lo que es bueno, que es decidir que «Alfredo» en esta frase es un diseñador. La base de datos aporta aquello en lo que es buena, que es saber que el diseñador es Alfredo Häberli. Es la misma división del trabajo que la de toda la arquitectura, aplicada un nivel más abajo.
Mide el selector de esquema en lugar de suponer que es semántico. Seis campos de alta prioridad están siempre presentes, y un comparador por palabras clave selecciona el resto a partir de las etiquetas, claves y palabras clave de los campos. En dos consultas realistas aportó dos y tres campos de 86, y el tope de 25 no llegó a limitar. Sigue siendo suficiente porque el prompt contiene además los seis campos siempre activos y el catálogo completo de metadatos, no porque la coincidencia de subcadenas sea un buen método de recuperación.
Validar y reintentar la salida estructurada
Un JSON válido es solo el primer paso de validación. Un árbol bien formado aún puede hacer referencia a asset.file_type, por ejemplo, aunque ese campo no exista.
Por eso la validación se ejecuta en dos capas. La primera comprueba la estructura: las tres claves obligatorias, una intención tomada de las seis permitidas, un rule_group con type, operator y rules. La segunda recorre el árbol de forma recursiva y comprueba el nombre de campo de cada hoja contra el mismo registro que lee el editor de filtros de la galería. Un campo no registrado es un rechazo firme, no una advertencia, porque un filtro sobre un campo inexistente o bien no compila o, peor, compila en algo que no coincide con nada sin avisar.
Cuando hay un rechazo, los errores no se convierten en una excepción. Se convierten en el siguiente turno de usuario:
ERROR: Your previous response had validation errors:
Invalid field 'asset.file_type': The field 'file_type' does not exist.
Use 'asset.mime_type' (for MIME types like 'image/jpeg') or
'asset.extension' (for file extensions like 'jpg') instead.

Please correct these errors and provide a valid response
following the exact schema.
La respuesta inválida se añade como turno del asistente y el error de validación como siguiente turno del usuario, y se envían de nuevo ambos para un intento de corrección. Los errores más comunes incluyen texto de remediación, porque nombrar el reemplazo permitido es más útil que decir solamente que el campo no está registrado.
Hay dos bucles de reintento anidados. Los fallos de transporte tienen un reintento tras una espera de dos segundos. Los fallos de validación tienen un reintento con retroalimentación. El peor caso antes de que el usuario vea un mensaje de respaldo son, por tanto, cuatro llamadas al modelo, y con un tiempo de espera de 45 segundos por llamada es un límite superior que supera con holgura la paciencia de la mayoría de los proxies inversos. No hemos medido con qué frecuencia se llega al bucle exterior en producción, y la lectura honesta es que ese límite es un dato de diseño y no un valor observado.
Tras la validación estructural, los valores de las hojas reciben una normalización específica de cada dominio. Los valores de color pueden llegar como #f00, FF0000 o {"hex": "#ff0000"}, de modo que el constructor expande el hexadecimal corto, normaliza mayúsculas y puntuación, y aplica la tolerancia por defecto cuando hace falta. Así se aceptan grafías equivalentes sin gastar otra ida y vuelta al modelo.
Mantener el estado en el árbol de reglas
Un diseño simple hace del historial el estado y pide al modelo que reconstruya los filtros acumulados en cada turno. Esa reconstrucción puede ir desajustándose a medida que crece el historial, y no deja ningún objeto explícito que la galería pueda abrir, guardar o compartir.
En freedam el estado es el árbol de reglas, almacenado en la sesión y actualizado una vez por turno. El historial es contexto, limitado a los últimos diez mensajes, y si se descartara por completo la búsqueda actual sobreviviría intacta. En cada turno se le indica al modelo el árbol actual completo, y se le pide que no lo repita, solo que describa la diferencia y la etiquete con una intención.
Como el estado es un árbol, «abrir en la galería» puede pasar los filtros acumulados al editor de reglas normal, donde los usuarios pueden inspeccionarlos, guardarlos, compartirlos o automatizarlos. El traspaso solo adapta la forma del nivel superior. Los árboles de producción pueden tener varias capas envolventes, así que tanto el recorrido como las pruebas necesitan fixtures anidados en lugar de suponer que cada filtro es hijo directo de la raíz.
La fusión actual tiene tres limitaciones conocidas, encontradas durante la revisión del código y no a partir de reportes de soporte.
Refinar un campo y un operador existentes no reemplaza su valor. La deduplicación compara el campo y el operador pero ignora el valor, así que al refinar width > 1000 con width > 2000 se conserva la primera regla. Esto resuelve los filtros repetidos, pero no las actualizaciones de valor.
Quitar una regla exige una coincidencia exacta del valor. «Quita el filtro de ancho» solo funciona cuando el modelo reproduce exactamente el campo, el operador y el valor almacenados; en caso contrario, el árbol no cambia.
Quitar una regla solo recorre el nivel superior. Los grupos anidados, incluidos los grupos OR generados para las búsquedas por paleta, no se pueden quitar por la vía dirigida, aunque restablecer la búsqueda sigue funcionando.
Ninguno de estos casos lanza un error, y la explicación generada aún puede describir el cambio solicitado. Por eso necesitan aserciones posteriores a la fusión que comparen la operación solicitada con el árbol resultante, siguiendo el enfoque de pruebas de fallos del artículo de medición.
Recordar un término ambiguo
«Paisaje» puede describir una orientación o un tema, y ambas lecturas son comunes en una biblioteca de fotos. Por eso el sistema pide una aclaración en lugar de elegir una de forma implícita.
El tratamiento es pequeño y vale la pena copiarlo. La palabra se registra en la sesión como una memoria de tres estados, almacenada junto al árbol de reglas.
Dos propiedades hacen que funcione. Se infiere del comportamiento: la resolución se deriva inspeccionando el árbol fusionado en busca de un filtro de orientación o de la palabra dentro de un valor de búsqueda, nunca de que el modelo diga qué lectura eligió. Y es persistente: una vez resuelta, la interpretación se afirma en cada prompt posterior, de modo que el turno siete no invierte en silencio el significado que fijó el turno dos.
Cuando el término no está resuelto, el modelo devuelve la intención clarify, que no cambia ningún filtro y no ejecuta ninguna búsqueda. El marcador de desconocido se sigue persistiendo para que el sistema recuerde que preguntó. Un turno de aclaración cuesta, por tanto, una llamada al modelo y cero consultas a la base de datos.
Hoy se tratan así dos palabras, landscape y portrait. El mecanismo es general y el vocabulario no, y la razón es práctica y no de principio: esas son las dos que observamos. Una lista de ambigüedades por tenant, aprendida a partir de los resultados de las aclaraciones, es la siguiente versión obvia y todavía no existe.
La respuesta se escribe antes de que se ejecute la recuperación
Este orden crea una brecha entre lo que pidió el modelo y lo que la capa de recuperación acabó ejecutando.
El modelo produce su explanation en el paso 2, mientras que la búsqueda se ejecuta en el paso 6. Si la consulta estricta no devuelve nada y la recuperación la amplía mediante tolerancia a errores tipográficos o coincidencia por prefijo, la explicación sigue describiendo la consulta que pidió el modelo y no la que produjo los resultados.
En lugar de volver a llamar al modelo, el resultado de la búsqueda lleva una descripción estructurada del modo ejecutado: strict, typo o prefix, además de los términos original y de respaldo. La interfaz lo muestra en un aviso separado debajo de la respuesta. La galería y la API REST exponen hoy solo la sugerencia distinta «¿quisiste decir?», así que este aviso de ejecución todavía no es coherente en todas las superficies.
En general, la información que se descubre después de la generación necesita un canal de interfaz basado en el resultado determinista y no en la predicción del modelo.
El mismo razonamiento rige la vista previa. Habría sido fácil dar al chat su propia búsqueda ligera. No la tiene. La vista previa pasa por el mismo punto de entrada que usan los filtros avanzados de la galería, con el mismo perfil, la misma regla de orden por relevancia, los mismos topes de candidatos, el mismo informe de exhaustividad y las mismas reglas de acceso, resueltas a partir del propio usuario de la sesión. Falla en modo cerrado: una sesión cuyo usuario no se puede resolver lanza una excepción en lugar de recurrir a una búsqueda sin filtrar, porque la alternativa es una vista previa que muestra a alguien recursos que no tiene permiso de ver. Un par de pruebas de paridad fijan que el chat y la galería devuelvan los mismos recursos, los mismos totales y los mismos metadatos de respaldo para reglas idénticas, ejecutándose contra PostgreSQL real y no contra mocks, incluso con una regla de acceso que oculta parte de la biblioteca.
Cada una de estas rutas lleva además su propia identidad de llamador a la telemetría, chat_preview, chat_diagnostic, chat_suggestions, de modo que una búsqueda ejecutada en nombre de una conversación se distingue como tal en los registros y no se mezcla con el tráfico de la galería.
Explicar un resultado vacío
Un resultado vacío es más difícil en una interfaz conversacional, porque la explicación previa crea la expectativa de que el sistema entendió la solicitud.
Ante un resultado vacío, el sistema vuelve a ejecutar hasta cinco filtros de forma individual como consultas que solo cuentan, a través de la misma canalización con filtrado de acceso. Un desglose como diseñador Henning Koppel, 412 coincidencias; importados después del 1 de octubre, 88 coincidencias; orientación vertical, 0 coincidencias identifica el filtro restrictivo y da al usuario un siguiente paso útil.
Las sugerencias construidas encima leen esos conteos. Si varios filtros coinciden por separado pero no su conjunción, el sistema propone la disyunción. Si hay un rango de fechas, propone ampliarlo. Si hay una restricción de color o de dimensiones, propone relajarla. Y cuando una búsqueda devuelve una cantidad pequeña pero distinta de cero, entre una y cuatro, otro generador toma una muestra de las etiquetas de IA de los resultados y ofrece las etiquetas frecuentes que aún no están en la consulta, es decir, una expansión por ejemplo y no por regla.
| Resultado del turno | Llamadas al modelo | Búsquedas en la base de datos |
|---|---|---|
| Aclarar: el modelo hace una pregunta | 1 | 0 |
| Normal: cinco o más resultados | 1 | 1 |
| Pocos: de uno a cuatro resultados | 1 | 2 |
| Cero, con hasta cinco filtros | 1 | hasta 6 |
| JSON mal formado, recuperado en el reintento | 2 | 1 |
| Fallo de transporte, recuperado en el reintento | 2 | 1 |
| Se agotaron todos los reintentos | 4 | 0 |
La ruta de cero resultados usa más búsquedas en la base de datos pero ninguna llamada adicional al modelo, porque la base de datos puede explicar qué restricciones deterministas coincidieron. La ruta de reintentos agotados es más preocupante desde el punto de vista operativo: puede gastar cuatro llamadas al modelo y devolver aun así solo un mensaje de respaldo genérico.
Antes de este flujo, una llamada a un modelo más pequeño comprueba si el mensaje trata de recursos. Su respuesta se guarda en caché durante una hora según un hash del texto del mensaje. La comprobación falla en modo abierto cuando no está disponible, para que una protección auxiliar no bloquee solicitudes de búsqueda legítimas.
Alrededor hay los controles habituales: veinte mensajes por minuto y por usuario, un tope de 2000 caracteres por mensaje, sesiones que caducan a los treinta días, registro por mensaje de tokens y costo que se acumula en un total por sesión, y un interruptor de emergencia (kill switch) que puede activar cualquier monitor automático de costos, el cual desactiva la función durante veinticuatro horas mediante un indicador en la caché, sin necesidad de un despliegue.
Lo que le diríamos a cualquiera que construya esto
La versión transferible, sin los detalles propios.
- Usa el modelo para la interpretación y el motor de búsqueda para la recuperación. La interpretación cuesta una llamada sin importar el tamaño del corpus, mientras que la recuperación necesita acceso indexado a todo el corpus y a sus permisos.
- Haz que el modelo emita una estructura que tu producto ya ejecuta. Si la ruta conversacional tiene su propio lenguaje de consulta, tendrá sus propios errores, su propio ranking y, con el tiempo, su propia idea de lo que significan tus datos. El nuestro emite el mismo árbol de reglas que construye el editor manual de filtros.
- Valida contra tu registro real y devuelve los errores como un turno. La validación estructural no detecta nada interesante. Comprobar cada nombre de campo contra el mismo registro que lee el resto de la aplicación es lo que frena el disparate dicho con seguridad, y un modelo al que se le da una corrección concreta se corrige mucho más fiablemente que uno al que solo se le dice que se equivocó.
- Guarda el estado conversacional en la estructura, no en el historial. El estado que vive en prosa se va desajustando y no se puede exportar. El estado que vive en un árbol se puede pasar a un editor de filtros, guardar, compartir o asociar a una automatización, y sobrevive al truncamiento del historial.
- Genera la mayor parte del prompt a partir de la propia base de datos del tenant, y muestrea valores en lugar de enumerar el esquema. El nuestro se genera en un 45 %. Un modelo al que se le muestra que los valores reales de un campo se parecen a Henning Koppel asigna un apellido a ese campo; un modelo al que solo se le dice que el campo existe, adivina.
- Nunca le pidas un identificador a un modelo. Dale operadores de texto y resuelve a claves en tu compilador con coincidencia aproximada. El lenguaje es tarea del modelo; la identidad, de la base de datos.
- Da por hecho que el resumen del modelo es una predicción, y dale a la interfaz su propio canal. Todo lo que se descubra después de que el modelo hable, una consulta ampliada, un total truncado, un respaldo, tiene que llegar al usuario a través de un componente que el modelo no pueda escribir.
- Ejecuta la misma búsqueda que ejecuta todo lo demás, con los mismos permisos, y etiqueta al llamador. Una superficie conversacional con su propia ruta de recuperación es un segundo motor de búsqueda que discrepará en silencio del primero.
- Gasta consultas en explicar un resultado vacío. Los conteos por filtro convierten un callejón sin salida en el siguiente turno, y son baratos justo en el sentido en que no lo es una segunda llamada al modelo.
- Documenta lo que tu semántica de fusión no puede expresar. La nuestra no puede actualizar el valor de un filtro mediante refine, no puede quitar uno anidado, y en ambos casos informa de éxito. Son los fallos sobre los que un usuario nunca abre un ticket, porque el sistema sonó seguro.
Dónde vive esto en el producto
La búsqueda conversacional es una superficie más sobre el motor de recuperación descrito a lo largo de esta serie, no un sistema paralelo. El árbol que construye se ejecuta como la misma consulta fusionada de BM25 y pgvector que todo lo demás, respeta las mismas reglas de control de acceso, resuelve los mismos vocabularios controlados y se mide con el mismo instrumento de relevancia. Nada de la llamada al modelo es privilegiado. Si desactivas la función, cualquier búsqueda que pueda expresar sigue siendo expresable a mano en los filtros de la galería.
La misma arquitectura es lo que hace coherente, y no redundante, la integración MCP. Un agente de IA externo que se conecta por MCP hace exactamente lo mismo que el chat integrado: traduce el lenguaje a una consulta y deja que PostgreSQL recupere, y pasa por el mismo punto de entrada con su propia identidad de llamador. El chat no es la función de IA; es un cliente más de un motor de búsqueda diseñado para ser manejado por un programa.
Los límites merecen enunciarse tan claramente como el diseño. Las mediciones del prompt provienen de un único tenant de desarrollo con 22.944 recursos y 48 definiciones de metadatos, y el tamaño del prompt crece con el catálogo de metadatos del tenant, de modo que todavía no hemos acotado el costo para una biblioteca con varios cientos de definiciones. Los tres defectos de fusión descritos arriba se encontraron leyendo el código y aún no están corregidos, y el selector de campos sigue siendo un comparador de subcadenas. Tampoco tenemos una medición en producción de con qué frecuencia ocurren los reintentos de validación, así que ese es el siguiente comportamiento que hay que instrumentar en lugar de estimar.