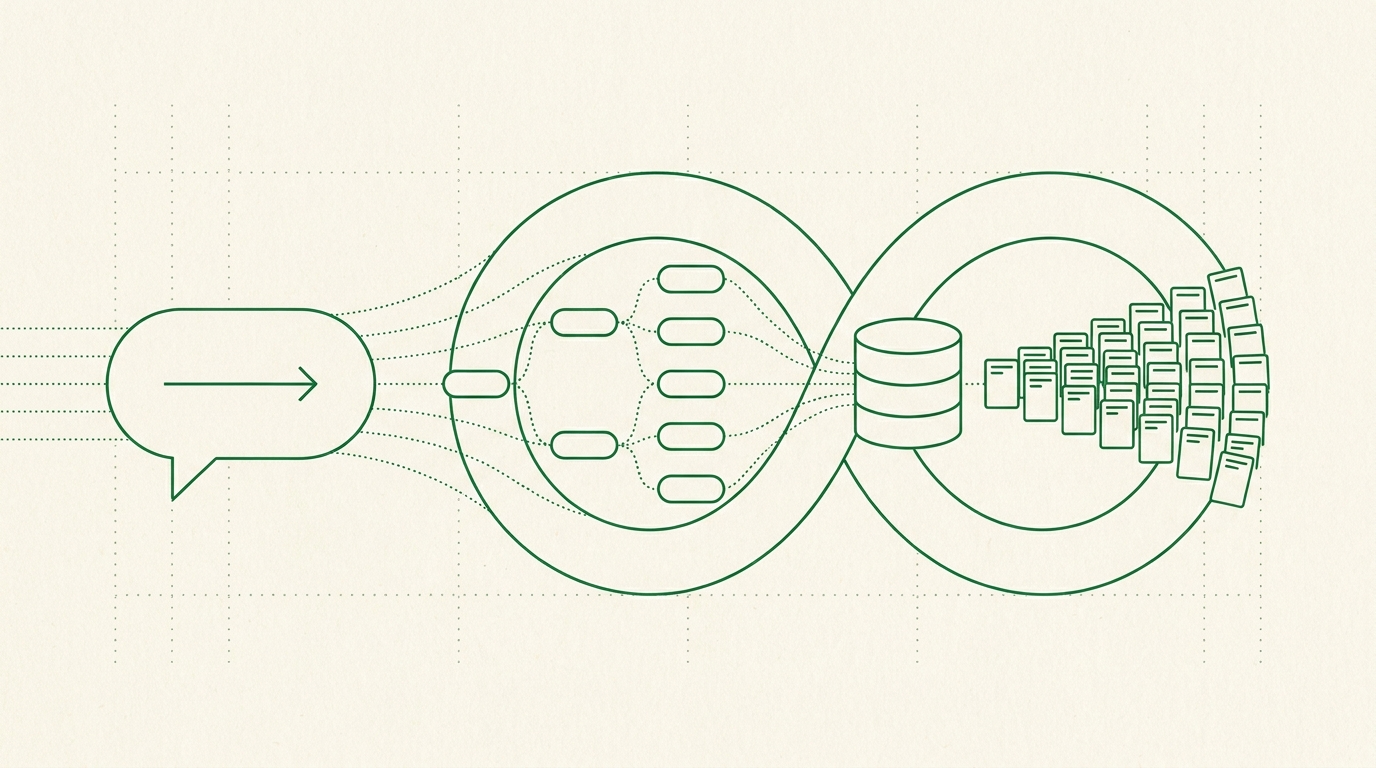
Le chat qui ne voit jamais votre photothèque
Une première version courante de la recherche conversationnelle envoie une phrase et un échantillon de médias à un modèle de langage, puis lui demande de choisir ceux qui conviennent. Cela peut fonctionner dans une petite démonstration, mais cela ne passe pas à l’échelle de la photothèque et ne peut pas tenir compte des médias situés hors de la fenêtre de contexte.
freedam utilise à la place le modèle uniquement pour transformer une phrase en arbre de filtres ; le modèle ne reçoit aucun média et n’en classe aucun. L’arbre est exécuté par le moteur de recherche décrit dans l’article sur l’architecture, avec BM25 et pgvector dans PostgreSQL, sous les mêmes règles d’accès et la même logique de décompte des résultats que la galerie.
Cet article présente les avantages et les coûts de cette frontière : un état qui survit à la troncature de la conversation, des réponses produites avant l’exécution de la recherche, et trois limites actuelles dans la fusion de l’arbre de règles.
Séparer l’interprétation de la recherche
« Rechercher avec l’IA » combine l’interprétation et la recherche, mais ces deux tâches n’ont pas le même profil de coût.
Interpréter une requête a un coût à peu près fixe. « Quelque chose de calme pour l’en-tête de la newsletter, en paysage, pas ceux du printemps dernier » contient une ambiance, un format d’image et une exclusion temporelle, et extraire ces contraintes coûte un appel au modèle, que la photothèque contienne quatre cents médias ou quatre cent mille.
Rechercher dans le corpus est une tâche à gros volume dont le coût croît avec la photothèque : elle relève donc de requêtes indexées en base de données, pas du contexte d’un modèle.
La frontière influence aussi le compte rendu des résultats. Un moteur de recherche peut indiquer qu’il a trouvé 1 247 correspondances, ou qu’un plafond de candidats fait du total une borne inférieure, grâce au compte rendu d’exhaustivité partagé avec le reste de la pile de recherche. Un modèle qui ne reçoit qu’une page de médias ne peut pas distinguer un corpus vide d’un échantillon incomplet, ce qui rend sa réponse inadaptée aux opérations en masse.
Nous laissons donc le modèle interpréter le langage, et PostgreSQL rechercher dans la photothèque.
Ce que produit le modèle
Un tour produit exactement un objet JSON, qui comporte trois clés.
{
    "intent": "refine",
    "rule_group": {
        "type": "group",
        "operator": "and",
        "rules": [
            {
                "field": "full_text_search",
                "operator": "hybrid_search",
                "value": "sunset"
            },
            {
                "field": "asset.aspect_ratio_orientation",
                "operator": "equals",
                "value": "landscape"
            }
        ]
    },
    "explanation": "Narrowing to landscape shots with sunset colours."
}
rule_group est le même arbre de règles que construit l’éditeur de filtres avancés de la galerie, que sérialisent les recherches enregistrées et qui est compilé en SQL. Réutiliser cette structure évite un langage de requête propre au chat et garde la recherche conversationnelle sur le même chemin de classement et de recherche que le reste du produit.
intent indique ce qu’il faut faire de l’arbre par rapport à la conversation jusque-là. explanation est le seul langage naturel que l’utilisateur voit jamais, et le prompt système la limite à une phrase courte dans la langue d’interface de l’utilisateur. Cela compte plus qu’il n’y paraît, et c’est là que le travail multilingue réapparaît : les noms de champs, les noms d’opérateurs et les valeurs d’intent restent en anglais parce que ce sont des identifiants, alors que la phrase qui les entoure est générée en français ou en chinois simplifié.
Nous utilisons une température de 0,1, un format de réponse json_object et, quand il est pris en charge, la variante de routage Exacto d’OpenRouter, qui sélectionne les fournisseurs validés pour la sortie structurée. Le modèle par défaut est openai/gpt-oss-120b, un modèle open-weight de taille moyenne, parce que la tâche consiste à traduire vers un schéma validé en aval.
Générer le prompt à partir du schéma du tenant
Sur un tenant de développement avec 22 944 médias et 48 définitions de métadonnées, le prompt système fait 36 790 caractères sur 646 lignes. Parmi eux, 16 646 caractères, environ 45 %, sont générés à partir de la base de données du tenant pour la requête en cours.
La partie fixe, 19 840 caractères, est le squelette d’instructions : le schéma de sortie, les six intents, l’ordre de priorité des méthodes de recherche, les exemples travaillés, et une liste de choses à ne pas faire qui s’est allongée une entrée à la fois en observant des échecs réels. La partie générée est un catalogue du vocabulaire métier du tenant, assemblé par classe de média. C’est elle qui fait que le même prompt se comporte de façon totalement différente pour un revendeur de meubles et pour un fournisseur de pièces d’aviation.
Trois décisions de la section générée sont utiles au-delà de cette implémentation.
Échantillonner les valeurs, pas seulement le schéma. Pour chaque champ texte, le prompt contient les vingt-cinq valeurs les plus fréquentes réellement présentes dans la photothèque. Pour chaque champ numérique ou date, le minimum et le maximum observés. Pour chaque champ de vocabulaire, jusqu’à cinquante libellés de termes réels. Un modèle à qui l’on dit qu’un champ nommé product_designer existe devinera ; un modèle à qui l’on a montré que ses valeurs ressemblent à Henning Koppel et Louise Adelborg associera correctement un nom de famille à ce champ dès le premier essai.
Ne jamais faire deviner un identifiant au modèle. Les termes de vocabulaire sont des clés étrangères, et un modèle à qui l’on demande un identifiant de terme en inventera un qui passe l’analyse syntaxique. L’ensemble d’opérateurs comprend donc vocab_text_equals et vocab_text_in, qui prennent du texte lisible, et la résolution vers un identifiant se fait ensuite dans le compilateur, avec la similarité trigramme de PostgreSQL à un seuil de 0,45, après avoir essayé d’abord une correspondance exacte insensible à la casse. Le modèle apporte ce qu’il sait faire : décider que « Alfredo » dans cette phrase est un designer. La base de données apporte ce qu’elle sait faire : savoir que ce designer est Alfredo Häberli. C’est la même répartition du travail que dans toute l’architecture, appliquée un niveau plus bas.
Mesurer le sélecteur de schéma plutôt que le supposer sémantique. Six champs de haute priorité sont toujours présents, tandis qu’un moteur de mots-clés sélectionne les autres à partir des libellés, des clés et des mots-clés des champs. Sur deux requêtes réalistes, il a ajouté deux et trois champs sur 86, et le plafond de 25 n’a pas été atteint. Cela reste suffisant parce que le prompt contient aussi six champs toujours actifs et tout le catalogue de métadonnées, pas parce que la correspondance de sous-chaînes serait une bonne méthode de recherche.
Valider et relancer la sortie structurée
Un JSON valide n’est que la première étape de validation. Un arbre bien formé peut tout de même référencer asset.file_type, par exemple, alors que ce champ n’existe pas.
La validation se fait donc en deux couches. La première vérifie la structure : les trois clés obligatoires, un intent pris parmi les six autorisés, un rule_group portant type, operator et rules. La seconde parcourt l’arbre récursivement et vérifie le nom de champ de chaque feuille dans le même registre que celui lu par l’éditeur de filtres de la galerie. Un champ non enregistré est un rejet net, pas un avertissement, parce qu’un filtre sur un champ inexistant échoue à la compilation ou, pire, se compile en quelque chose qui ne correspond silencieusement à rien.
Quand un rejet se produit, les erreurs ne deviennent pas une exception. Elles deviennent le tour utilisateur suivant :
ERROR: Your previous response had validation errors:
Invalid field 'asset.file_type': The field 'file_type' does not exist.
Use 'asset.mime_type' (for MIME types like 'image/jpeg') or
'asset.extension' (for file extensions like 'jpg') instead.

Please correct these errors and provide a valid response
following the exact schema.
La réponse invalide est ajoutée comme tour de l’assistant et l’erreur de validation comme tour utilisateur suivant, puis les deux sont renvoyées pour une tentative de correction. Les erreurs courantes incluent un texte de remédiation, parce qu’indiquer le remplacement autorisé est plus utile que dire seulement que le champ n’est pas enregistré.
Deux boucles de nouvel essai sont imbriquées. Les échecs de transport obtiennent un nouvel essai après un délai de deux secondes. Les échecs de validation obtiennent un nouvel essai avec retour d’erreur. Le pire cas avant que l’utilisateur voie un message de repli est donc de quatre appels au modèle, et avec un délai maximal de 45 secondes par appel, c’est une borne supérieure qui dépasse largement la patience de la plupart des reverse proxies. Nous n’avons pas mesuré à quelle fréquence la boucle externe est atteinte en production. Il faut le lire honnêtement : cette borne est un fait de conception, pas une observation.
Après la validation structurelle, les valeurs des feuilles reçoivent une normalisation propre à leur domaine. Les couleurs peuvent arriver sous la forme #f00, FF0000 ou {"hex": "#ff0000"} ; le constructeur développe donc l’hexadécimal court, normalise la casse et la ponctuation, et fournit la tolérance par défaut si nécessaire. Cela accepte des écritures équivalentes sans dépenser un autre aller-retour avec le modèle.
Garder l’état dans l’arbre de règles
Une conception simple fait de la conversation l’état et demande au modèle de reconstituer les filtres accumulés à chaque tour. Cette reconstitution peut dériver à mesure que la conversation s’allonge, et elle ne laisse aucun objet explicite que la galerie puisse ouvrir, enregistrer ou partager.
Dans freedam, l’état est l’arbre de règles, stocké sur la session et mis à jour une fois par tour. La conversation sert de contexte, limitée aux dix derniers messages, et si elle était supprimée entièrement, la recherche en cours survivrait intacte. Le modèle reçoit l’arbre courant en entier à chaque tour, et on lui demande de ne pas le reformuler, seulement de décrire la différence et de l’étiqueter avec un intent.
Comme l’état est un arbre, « ouvrir dans la galerie » peut transmettre les filtres accumulés à l’éditeur de règles habituel, où les utilisateurs peuvent les examiner, les enregistrer, les partager ou les automatiser. Le passage de relais n’adapte que la forme du niveau supérieur. Les arbres en production peuvent contenir plusieurs couches d’enveloppe : le parcours et les tests ont donc tous deux besoin de fixtures imbriquées, au lieu de supposer que chaque filtre est un enfant direct de la racine.
La fusion actuelle a trois limites connues, découvertes lors d’une revue de code et non à partir de signalements du support.
Affiner un champ et un opérateur existants ne remplace pas leur valeur. La déduplication compare le champ et l’opérateur mais ignore la valeur : affiner width > 1000 avec width > 2000 conserve donc la première règle. Cela gère les filtres répétés, mais pas les mises à jour de valeur.
La suppression exige une valeur identique. « Retire le filtre de largeur » ne réussit que si le modèle reproduit exactement le champ, l’opérateur et la valeur enregistrés ; sinon l’arbre reste inchangé.
La suppression ne parcourt que le niveau supérieur. Les groupes imbriqués, y compris les groupes OR générés pour les recherches par palette, ne peuvent pas être supprimés par le chemin ciblé, alors que la réinitialisation de la recherche fonctionne toujours.
Aucun de ces cas ne lève d’erreur, et l’explication générée peut quand même décrire la modification demandée. Ils nécessitent donc des assertions après fusion qui comparent l’opération demandée à l’arbre obtenu, selon l’approche de test par injection de fautes décrite dans l’article sur la mesure.
Mémoriser un terme ambigu
« Paysage » (landscape) peut désigner une orientation ou un sujet, et les deux lectures sont courantes dans une photothèque. Le système demande donc une précision au lieu d’en choisir une implicitement.
Le traitement est simple et mérite d’être repris. Le mot est suivi dans la session par une mémoire à trois états, stockée à côté de l’arbre de règles.
Deux propriétés la font fonctionner. Elle est déduite du comportement : la résolution est dérivée en inspectant l’arbre fusionné à la recherche d’un filtre d’orientation ou du mot apparaissant dans une valeur de recherche, jamais d’une déclaration du modèle sur la lecture qu’il a choisie. Et elle est persistante : une fois résolue, l’interprétation est affirmée dans chaque prompt suivant, de sorte que le septième tour ne renverse pas discrètement le sens établi au deuxième.
Quand le terme n’est pas résolu, le modèle renvoie l’intent clarify, qui ne modifie aucun filtre et ne lance aucune recherche. Le marqueur unknown est tout de même enregistré pour que le système se souvienne d’avoir posé la question. Un tour de clarification coûte donc un appel au modèle et zéro requête en base.
Deux mots sont traités ainsi aujourd’hui, landscape et portrait. Le mécanisme est général, le vocabulaire ne l’est pas, et la raison est pratique plutôt que théorique : ce sont les deux que nous avons observés. Une liste d’ambiguïtés par tenant, apprise à partir des résultats des clarifications, serait la version suivante évidente ; elle n’existe pas.
La réponse est écrite avant l’exécution de la recherche
Cet ordre crée un écart entre ce que le modèle a demandé et ce que la couche de recherche a finalement exécuté.
Le modèle produit son explanation à l’étape 2, alors que la recherche s’exécute à l’étape 6. Si la requête stricte ne renvoie rien et que la recherche l’élargit par tolérance aux fautes de frappe ou par correspondance de préfixe, l’explication décrit toujours la requête demandée par le modèle, pas celle qui a produit les résultats.
Plutôt que de rappeler le modèle, le résultat de recherche porte un compte rendu structuré du mode exécuté : strict, typo ou prefix, avec le terme d’origine et le terme de repli. L’interface l’affiche dans un avis distinct sous la réponse. La galerie et l’API REST n’exposent actuellement que la suggestion distincte « vouliez-vous dire », cet avis d’exécution n’est donc pas encore cohérent entre les surfaces.
Plus généralement, une information découverte après la génération a besoin d’un canal d’interface fondé sur le résultat déterministe plutôt que sur la prédiction du modèle.
Le même raisonnement s’applique à l’aperçu lui-même. Il aurait été facile de donner au chat sa propre recherche légère. Il n’en a pas. L’aperçu passe par le même point d’entrée que les filtres avancés de la galerie, avec le même profil, la même règle de tri par pertinence, les mêmes plafonds de candidats, le même compte rendu d’exhaustivité et les mêmes règles d’accès, résolues à partir de l’utilisateur de la session elle-même. Il échoue en mode fermé : une session dont l’utilisateur ne peut pas être résolu lève une exception au lieu de se rabattre sur une recherche non filtrée, car l’alternative serait un aperçu montrant à quelqu’un des médias qu’il n’a pas le droit de voir. Une paire de tests de parité impose au chat et à la galerie les mêmes médias, les mêmes totaux et les mêmes métadonnées de repli pour des règles identiques, en s’exécutant sur un vrai PostgreSQL plutôt que sur des mocks, y compris sous une règle d’accès qui masque une partie de la photothèque.
Chacun de ces chemins transmet aussi sa propre identité d’appelant à la télémétrie (chat_preview, chat_diagnostic, chat_suggestions), de sorte qu’une recherche exécutée pour le compte d’une conversation est lisible comme telle dans les logs, au lieu de se fondre dans le trafic de la galerie.
Expliquer un résultat vide
Un résultat vide est plus difficile dans une interface conversationnelle, parce que l’explication qui le précède crée l’attente que le système a compris la demande.
Pour un résultat vide, le système relance individuellement jusqu’à cinq filtres sous forme de requêtes de comptage seul, via le même pipeline filtré par les droits d’accès. Une ventilation comme designer Henning Koppel, 412 correspondances ; importé après le 1er octobre, 88 correspondances ; orientation portrait, 0 correspondance identifie le filtre restrictif et donne à l’utilisateur une prochaine étape utile.
Les suggestions construites par-dessus lisent ces décomptes. Si plusieurs filtres correspondent individuellement mais pas leur conjonction, le système propose la disjonction. Si une plage de dates est présente, il propose de l’élargir. Si une contrainte de couleur ou de dimension est présente, il propose de l’assouplir. Et quand une recherche renvoie un nombre petit mais non nul, entre un et quatre, un autre générateur échantillonne les tags IA des résultats et propose les tags fréquents qui ne figurent pas déjà dans la requête : c’est une expansion par l’exemple plutôt que par la règle.
| Issue du tour | Appels au modèle | Recherches en base |
|---|---|---|
| Clarify : le modèle pose une question | 1 | 0 |
| Normal : cinq résultats ou plus | 1 | 1 |
| Peu : un à quatre résultats | 1 | 2 |
| Zéro, avec jusqu’à cinq filtres | 1 | jusqu’à 6 |
| JSON malformé, récupéré au nouvel essai | 2 | 1 |
| Échec de transport, récupéré au nouvel essai | 2 | 1 |
| Tous les nouveaux essais épuisés | 4 | 0 |
Le chemin du résultat nul utilise le plus de recherches en base, mais aucun appel supplémentaire au modèle, parce que la base peut expliquer quelles contraintes déterministes correspondaient. Le chemin où tous les nouveaux essais sont épuisés est plus préoccupant sur le plan opérationnel : il peut dépenser quatre appels au modèle et ne renvoyer qu’un message de repli générique.
Avant ce flux, un appel à un modèle plus petit vérifie si le message concerne des médias. Sa réponse est mise en cache pendant une heure, sous la clé d’un hash du texte du message. La vérification laisse passer en cas d’indisponibilité (fail open), pour qu’un garde-fou auxiliaire ne puisse pas bloquer des demandes de recherche légitimes.
Autour, on trouve les contrôles habituels : vingt messages par minute et par utilisateur, un plafond de 2 000 caractères par message, des sessions qui expirent au bout de trente jours, un enregistrement des tokens et du coût par message, cumulé en un total par session, et un kill switch que n’importe quel moniteur de coûts automatisé peut actionner, qui désactive la fonctionnalité pendant vingt-quatre heures via un indicateur de cache, sans déploiement.
Ce que nous dirions à quiconque construit cela
La version transposable, sans nos particularités.
- Utilisez le modèle pour l’interprétation et le moteur de recherche pour la recherche. L’interprétation coûte un appel quelle que soit la taille du corpus, alors que la recherche exige un accès indexé à tout le corpus et à ses permissions.
- Faites émettre au modèle une structure que votre produit exécute déjà. Si le chemin conversationnel a son propre langage de requête, il aura ses propres bugs, son propre classement et, à terme, sa propre idée de ce que signifient vos données. Le nôtre émet le même arbre de règles que construit l’éditeur de filtres manuel.
- Validez par rapport à votre registre en production et renvoyez les erreurs comme un tour de conversation. La validation structurelle n’attrape rien d’intéressant. Vérifier chaque nom de champ dans le même registre que lit le reste de l’application est ce qui arrête les absurdités affirmées avec assurance, et un modèle à qui l’on donne une correction précise se corrige bien plus sûrement qu’un modèle à qui l’on dit qu’il s’est trompé.
- Gardez l’état conversationnel dans la structure, pas dans la conversation. Un état qui vit en prose dérive et ne peut pas être exporté. Un état qui vit dans un arbre peut être transmis à un éditeur de filtres, enregistré, partagé ou rattaché à une automatisation, et il survit à la troncature de la conversation.
- Générez la plus grande partie de votre prompt à partir de la base de données du tenant, et échantillonnez les valeurs plutôt que de lister le schéma. Le nôtre est généré à 45 %. Un modèle à qui l’on montre que les vraies valeurs d’un champ ressemblent à Henning Koppel associe un nom de famille à ce champ ; un modèle à qui l’on dit seulement que le champ existe devine.
- Ne demandez jamais un identifiant à un modèle. Donnez-lui des opérateurs de texte et résolvez vers les clés dans votre compilateur, avec une correspondance approximative. Le langage est le travail du modèle ; l’identité est celui de la base de données.
- Considérez que le résumé du modèle est une prédiction, et donnez à l’interface son propre canal. Tout ce qui est découvert après que le modèle a parlé (une requête élargie, un total tronqué, un repli) doit atteindre l’utilisateur par un composant que le modèle ne peut pas écrire.
- Exécutez la même recherche que tout le reste, sous les mêmes permissions, et étiquetez l’appelant. Une surface conversationnelle dotée de son propre chemin de recherche est un second moteur de recherche qui divergera silencieusement du premier.
- Dépensez des requêtes pour expliquer un résultat vide. Des décomptes par filtre transforment une impasse en tour suivant, et ils sont peu coûteux, ce qu’un second appel au modèle n’est pas.
- Écrivez ce que votre sémantique de fusion ne sait pas exprimer. La nôtre ne sait pas mettre à jour la valeur d’un filtre via refine, ne sait pas en retirer un imbriqué, et signale un succès dans les deux cas. Ce sont des échecs dont l’utilisateur n’ouvre jamais de ticket, parce que le système avait l’air sûr de lui.
Où cela se trouve dans le produit
La recherche conversationnelle est une surface au-dessus du moteur de recherche décrit dans cette série, pas un système parallèle. L’arbre qu’elle construit s’exécute comme la même requête fusionnée BM25 et pgvector que tout le reste, respecte les mêmes règles de contrôle d’accès, résout les mêmes vocabulaires contrôlés et se mesure avec le même instrument de pertinence. Rien dans l’appel au modèle n’est privilégié. Désactivez la fonctionnalité et toute recherche qu’elle sait exprimer reste exprimable à la main dans les filtres de la galerie.
Cette même architecture rend l’intégration MCP cohérente plutôt que redondante. Un agent IA externe qui se connecte via MCP fait exactement ce que fait le chat intégré : il traduit le langage en requête et laisse PostgreSQL faire la recherche, en passant par le même point d’entrée avec sa propre identité d’appelant. Le chat n’est pas la fonctionnalité d’IA ; c’est un client d’un moteur de recherche conçu pour être piloté par un programme.
Les limites méritent d’être énoncées aussi simplement que la conception. Les mesures du prompt proviennent d’un seul tenant de développement avec 22 944 médias et 48 définitions de métadonnées, et la taille du prompt croît avec le catalogue de métadonnées du tenant : nous n’avons donc pas encore borné le coût pour une photothèque de plusieurs centaines de définitions. Les trois défauts de fusion décrits plus haut ont été trouvés à la lecture et ne sont pas encore corrigés, et le sélecteur de champs reste un moteur de correspondance de sous-chaînes. Nous n’avons pas non plus de mesure en production de la fréquence des nouveaux essais de validation : c’est le prochain comportement à instrumenter plutôt qu’à estimer.