¿Por qué es tan difícil encontrar imágenes en unidades compartidas?
Alguien te pide la foto de los dos ingenieros en la planta de la fábrica, la que se usó en el informe anual de 2024. Sabes que existe. Quizá tú mismo la abriste. Veinte minutos después has encontrado cuatro candidatas, ninguna es esa, y le escribes a la persona que la tomó.
No es un problema de disciplina y no se soluciona poniendo mejores nombres a los archivos. Es una consecuencia de lo que indexa una búsqueda de archivos. Esta guía describe qué lee realmente Google Drive y Dropbox de una imagen, qué hay dentro del archivo que nunca abren y qué tiene que indexar un sistema para responder esa pregunta en una sola consulta.
Esta es la parte 2 de una serie de cuatro. La parte 1 trata de los límites publicados de capacidad y de versiones, la parte 3 de los derechos y el registro de auditoría y la parte 4 de la migración.
Qué indexa una búsqueda de archivos
Google publica sus operadores de búsqueda de Drive. La lista completa es lo bastante corta como para leerla:
owner:, creator:, to:, from:, app:, sharedwith:, is:starred, is:trashed, type:, before:, after:, createdbefore:, createdafter:, title:, followup:, unorganized:, además de frases entre comillas y exclusiones con el signo menos.
Vuelve a leer esa lista pensando en una biblioteca de fotos. Cada operador se refiere a una de tres cosas: quién tocó el archivo, cuándo lo tocó o cómo se llama. type:image es el único término que entiende de imágenes, y lo único que hace es limitar los resultados a imágenes.
No hay ningún operador para una descripción. Ninguno para una palabra clave. Ninguno para un fotógrafo, un motivo, un lugar descrito en lugar de dado como coordenadas GPS, una licencia, una campaña o un estado de aprobación. La ausencia es el hallazgo. La propia referencia de Drive es la declaración más clara de para qué sirve la búsqueda de Drive, y no sirve para encontrar una imagen por lo que contiene.
La búsqueda de texto completo sí funciona, y funciona bien, con cosas hechas de texto. Un documento de Google, un PDF con capa de texto, una hoja de cálculo: Drive indexa las palabras que contienen y las encuentra. Por eso los equipos cuyas bibliotecas son sobre todo documentos nunca notan el problema, y por eso esos mismos equipos se sorprenden cuando el departamento de marketing dice que la búsqueda está rota.
Qué lee Drive de una foto
Esta es la parte en la que conviene ser preciso, porque está documentada y casi nunca se cita.
El recurso de archivo de la API de Drive de Google define un objeto imageMediaMetadata. Es el conjunto completo de propiedades de imagen que Drive extrae y guarda. Estos son todos sus campos:
flashUsed, meteringMode, sensor, exposureMode, colorSpace, whiteBalance, width, height, location (latitud, longitud, altitud), rotation, time, cameraMake, cameraModel, exposureTime, aperture, focalLength, isoSpeed, exposureBias, maxApertureValue, subjectDistance, lens.
Diecinueve campos. Apertura, ISO, distancia focal, modo de medición, balance de blancos, qué objetivo se montó. Drive lee con todo detalle los ajustes de la cámara a partir de la fotografía, y no lee nada de lo que escribió el fotógrafo.
No hay ningún campo para una descripción, un titular, una palabra clave, un autor, un aviso de derechos de autor, un crédito ni unas condiciones de uso. La documentación de la API no tiene ningún campo IPTC ni XMP de ningún tipo.
El video es todavía más escaso. videoMediaMetadata tiene tres campos: width, height, durationMillis.
Qué hay dentro del archivo que nadie abre
Una fotografía lleva tres bloques de metadatos distintos, y cumplen funciones diferentes.
EXIF lo escribe la cámara. Obturador, apertura, ISO, objetivo, marca de tiempo y, a veces, GPS. Este es el bloque que lee Drive.
IPTC lo escriben las personas. El estándar de metadatos fotográficos IPTC es la convención de la prensa y de la fotografía de stock que usan las redacciones gráficas desde hace décadas, y contiene los campos que responden a una búsqueda: Descripción, que es el pie de foto; Palabras clave; Autor; Aviso de derechos de autor; Línea de crédito; Condiciones de uso de los derechos; Ubicación como nombre de lugar y no como coordenadas.
XMP es el formato contenedor de Adobe, escrito por Lightroom, Photoshop, Bridge y Capture One. Lleva campos IPTC además de valoraciones, etiquetas de color, historial de edición y esquemas personalizados.
La entrega de cualquier fotógrafo profesional ya trae IPTC y XMP rellenados. Es parte de lo que pagaste. Las descargas de una biblioteca de fotografía de stock los traen. Una década de entregas de agencias los trae. Cuando esos archivos llegan a una unidad compartida, ese trabajo se vuelve invisible, porque nada en la unidad lo lee, lo indexa ni lo muestra. El pie de foto sigue dentro del archivo. No hay forma de buscarlo.
El resultado práctico es un equipo que escribe los pies de foto en los nombres de archivo, o en una hoja de cálculo junto a los nombres, recreando a mano los metadatos que el archivo ya contiene.
Las propiedades personalizadas y por qué no cierran la brecha
Drive tiene un mecanismo para metadatos arbitrarios. La API de propiedades personalizadas de archivo permite a una aplicación asociar pares clave-valor a un archivo, y se pueden buscar. Los límites están publicados:
| Límite | Valor |
|---|---|
| Propiedades personalizadas por archivo | 100, de todas las fuentes |
| Propiedades públicas por archivo | 30 |
| Propiedades privadas por archivo y aplicación | 30 |
| Tamaño de la cadena de cada propiedad, clave y valor juntos, UTF-8 | 124 bytes |
La última fila es la que acaba con la idea. 124 bytes para la clave y el valor juntos. El propio ejemplo de Google: una clave de 10 caracteres deja 114 caracteres para el valor.
Un pie de foto no cabe en 114 caracteres. Tampoco una declaración de condiciones de uso, una nota de la lista de tomas ni una lista de palabras clave de longitud útil. Podrías guardar un término controlado corto, y entonces necesitarías una aplicación que lo escriba, una aplicación que lo lea y una convención que todos los que importan sigan. En ese punto has empezado a construir una biblioteca multimedia sobre un sistema de archivos, que es un proyecto de ingeniería razonable y algo extraño de hacer por accidente.
Dropbox no tiene ningún modelo comparable de metadatos descriptivos para los archivos.
Los cuatro índices que necesita una biblioteca multimedia
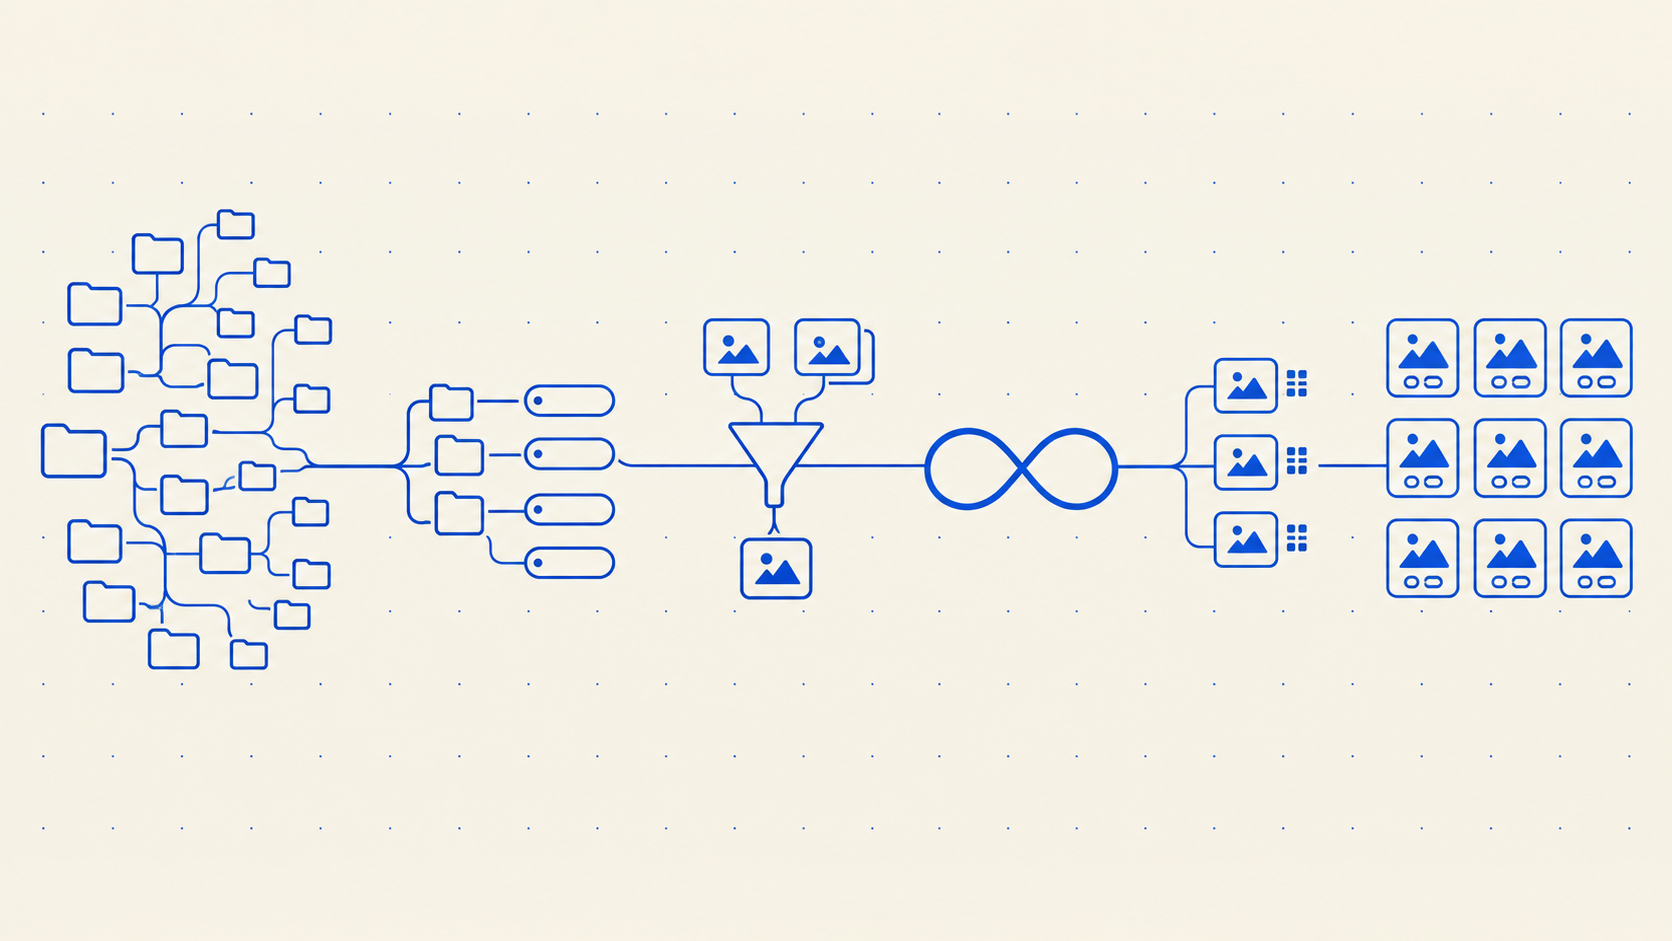
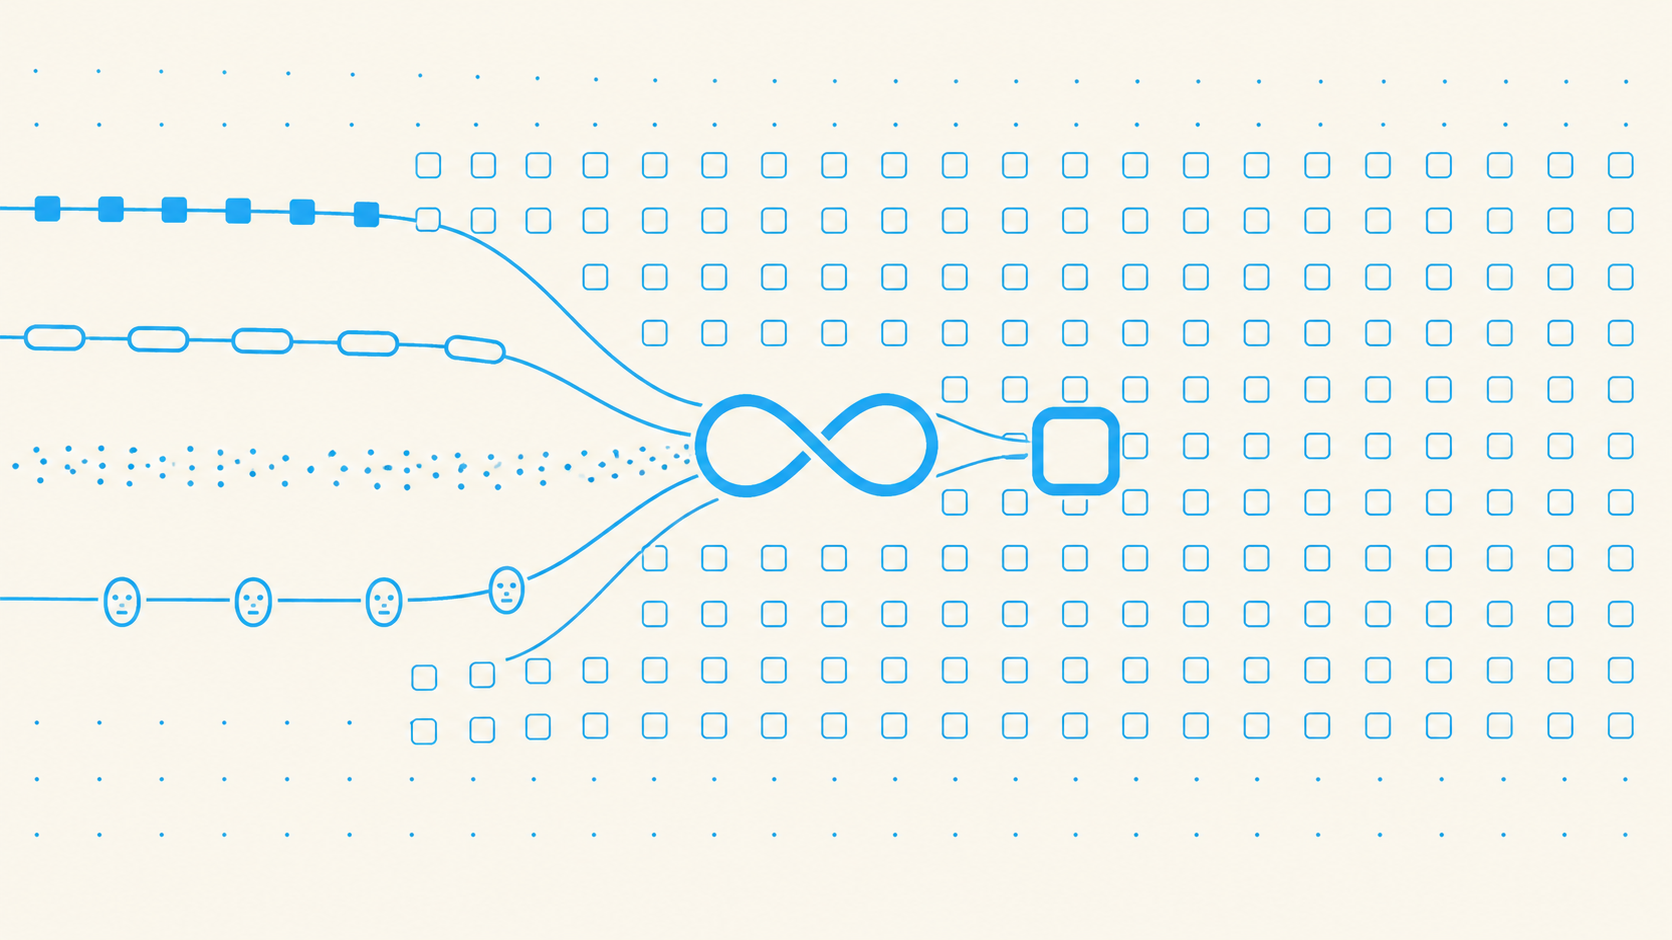
Encontrar una imagen por lo que contiene no es una sola función. Son cuatro índices distintos, cada uno construido de una forma, cada uno responde a una pregunta diferente y cada uno falla a su manera. Un sistema que tiene uno de ellos y afirma haber resuelto la búsqueda te decepcionará de una forma concreta y previsible.
Texto dentro de la imagen
El OCR lee las palabras representadas en los píxeles: el titular de un cartel, la etiqueta de un envase, el nombre en una diapositiva, el pie incrustado en un recurso para redes sociales. Así encuentras la campaña de la que recuerdas el eslogan y no el nombre de archivo.
Falla con la escritura a mano, con tipografías muy estilizadas, con texto en ángulos extremos y con palabras que están en la imagen pero no en el idioma que espera el índice. Acierta con mucha más frecuencia de la que se supone, porque una proporción sorprendente de los recursos de marketing son sobre todo tipografía.
Palabras clave y taxonomía
Las palabras clave IPTC que ya están en el archivo, más lo que añada la organización: códigos de producto, nombres de campaña, mercado, canal, estado de aprobación. Un vocabulario controlado y una taxonomía convierten esto de texto libre en algo que puedes filtrar y contar.
Este índice es exacto y es el único que puede expresar un hecho que no se ve en la imagen. Ningún análisis de píxeles te dirá que una fotografía está autorizada para su uso en Alemania hasta 2027. Alguien tiene que registrarlo, y este es el campo donde va. La guía de buenas prácticas de metadatos explica cómo diseñar el esquema.
Falla cuando nadie lo rellena, y por eso valen tanto los campos que el fotógrafo ya escribió.
Significado
La búsqueda semántica convierte la imagen y la consulta en vectores y los compara, de modo que «dos ingenieros en la planta de una fábrica» encuentra una fotografía que nunca se describió con esas palabras. El mecanismo relacionado, la búsqueda visual, toma una imagen como consulta y encuentra imágenes parecidas.
Este es el índice que responde a la pregunta del principio de esta guía. Falla en la especificidad: encontrará fotografías de plantas de fábrica de forma fiable, pero no distinguirá de forma fiable la del informe de 2024 de la de 2023. Sirve para reducir 40.000 imágenes a doce, no para elegir una entre 40.000.
Si quieres la implementación y no el comportamiento, cómo se construye la búsqueda de imágenes es el artículo técnico.
Personas
La búsqueda por reconocimiento facial agrupa los rostros de una biblioteca para que todas las fotografías de una misma persona se puedan recuperar juntas, las haya etiquetado alguien o no. Para una organización que fotografía a su propio personal, clientes, ponentes o deportistas, suele ser el índice de mayor valor, porque «fotos de esa persona» es la petición más común y la que peor responden las carpetas.
Falla con rostros parciales, con niños a medida que crecen y con cambios fuertes de iluminación. También tiene consecuencias que corresponden a la parte 3: un sistema que puede encontrar todas las fotografías de una persona concreta es un sistema que tiene que poder respetar que esa persona retire su consentimiento.
Por qué importa la combinación
Cada índice por separado deja un hueco evidente. Juntos responden a una consulta compuesta de una sola pasada: fotografías de esta persona, tomadas en este evento, cuyo texto en la imagen menciona este producto, autorizadas para uso externo y sin los casi duplicados. Ningún índice por sí solo puede hacerlo. Un árbol de carpetas ni se acerca.
Casi duplicados y los once archivos llamados final
Una unidad compartida que contiene hero_final.jpg, hero_final_v2.jpg, hero_FINAL_use_this.jpg y ocho parientes es el estado final normal de una biblioteca basada en carpetas. Cada uno de esos archivos es un archivo genuino. La unidad hace bien en mostrarte todos. No tiene forma de saber que diez de ellos son recortes, exportaciones y variantes de color de una misma fotografía, porque compara nombres de archivo y nunca ha mirado los píxeles.
Una biblioteca multimedia trata esto como dos problemas separados.
La detección de casi duplicados compara imágenes por su contenido, de modo que una copia redimensionada, recomprimida o ligeramente recortada se reconoce como la misma imagen que llega dos veces. Es un problema de limpieza y de importación, que cubre la detección de duplicados.
Las versiones derivadas son la solución estructural. Un recurso, un registro, un conjunto de metadatos y derechos, con cada tamaño, recorte y formato generado a partir de él bajo demanda. El JPEG web y el TIFF de impresión dejan de ser dos archivos que pueden contradecirse y pasan a ser dos vistas de una misma cosa. Cuando cambian los derechos, cambian una sola vez.
Cómo es una buena solución
Dos comprobaciones que puedes hacer en cualquier biblioteca, incluida la que usas ahora.
La prueba del desconocido. Dale a alguien que se incorporó el mes pasado una petición con las palabras que usaría un colega: «la foto del nuevo envase sobre fondo blanco, horizontal, que autorizamos para impresión». Cronométrale. Si la encuentra preguntando a una persona, el índice de la biblioteca es la memoria de un colega.
La prueba del pie de foto. Toma una fotografía entregada por un profesional en los últimos dos años. Abre las propiedades de su archivo en Lightroom, Bridge, Photoshop o el inspector de Vista previa de macOS. Lee los campos Descripción y Palabras clave. Después busca en tu biblioteca una palabra distintiva de ese pie de foto. Si no devuelve nada, los metadatos por los que ya pagaste no se están usando.
Preguntas frecuentes
¿Busca Google Drive dentro de las imágenes?
La lista publicada de operadores de búsqueda de Drive cubre propietario, fechas, tipo de archivo y título, y no contiene ningún operador para metadatos de imagen ni para el contenido de la imagen. La API de Drive extrae de una fotografía diecinueve ajustes de cámara, como apertura, ISO y objetivo, y ningún campo descriptivo: ni pie de foto, ni palabras clave, ni autor, ni derechos de autor. Drive encuentra imágenes por el nombre de archivo, por quién es su propietario y por cuándo se añadieron.
¿Puedo buscar en Google Drive por palabras clave IPTC?
No. El recurso de archivo de Drive no tiene ningún campo IPTC ni XMP. Las palabras clave que un fotógrafo escribió en el archivo siguen dentro de él y no se indexan. La API de propiedades personalizadas de Drive puede guardar tus propios pares clave-valor, pero la cadena de cada propiedad está limitada a 124 bytes incluida la clave, lo que es demasiado poco para un pie de foto o una lista de palabras clave de cierta longitud.
¿Cuál es la diferencia entre EXIF e IPTC?
EXIF lo escribe la cámara y describe la exposición: obturador, apertura, ISO, objetivo, marca de tiempo y, a veces, GPS. IPTC lo escriben las personas y describe el contenido y los derechos: pie de foto, palabras clave, autor, aviso de derechos de autor, línea de crédito, condiciones de uso. Drive lee EXIF. Una biblioteca multimedia lee ambos y busca en IPTC.
¿Cómo se buscan imágenes por su contenido?
Con cuatro índices, usados juntos. El OCR lee el texto representado en la imagen. Las palabras clave y la taxonomía guardan hechos que no se ven, como los derechos y la aprobación. La búsqueda semántica y la visual comparan significado y aspecto, de modo que una descripción encuentra una imagen que nadie describió así. La agrupación de rostros reúne todas las fotografías de una misma persona. Cada uno tiene un modo de fallar distinto, y por eso un sistema con uno solo resulta poco fiable.
¿Se soluciona poniendo mejores nombres a los archivos?
Ayuda, pero no escala. Una convención de nombres es un acuerdo compartido que está en la cabeza de quienes la escribieron. Sobrevive a un equipo y no sobrevive a una persona nueva, a una segunda oficina, a una agencia o al día en que alguien tiene prisa. Tampoco puede expresar nada que cambie con el tiempo, como una aprobación que caduca o una licencia que caduca.
Siguiente en la serie: Enlaces compartidos, derechos y registro de auditoría. Anterior: los límites publicados. La búsqueda de Freedam ejecuta los cuatro índices sobre la misma biblioteca.