Pourquoi retrouver des images dans un drive partagé est si difficile ?
Quelqu’un demande la photo des deux ingénieurs sur le site de production, celle du rapport annuel 2024. Vous savez qu’elle existe. Vous l’avez peut-être même ouverte vous-même. Vingt minutes plus tard, vous avez trouvé quatre candidates, dont aucune n’est la bonne, et vous écrivez à la personne qui l’a prise.
Ce n’est pas un problème de discipline, et mieux nommer les fichiers ne le résout pas. C’est la conséquence de ce qu’indexe une recherche de fichiers. Ce guide décrit ce que Google Drive et Dropbox lisent réellement dans une image, ce que contient le fichier sans qu’ils l’ouvrent jamais, et ce qu’un système doit indexer à la place pour répondre à cette question en une seule requête.
Ce guide est la partie 2 d’une série de quatre. La partie 1 traite des limites publiées de capacité et de versionnage, la partie 3 des droits et de la piste d’audit, et la partie 4 de la migration.
Ce qu’indexe une recherche de fichiers
Google publie ses opérateurs de recherche Drive. La liste complète est assez courte pour être lue en entier :
owner:, creator:, to:, from:, app:, sharedwith:, is:starred, is:trashed, type:, before:, after:, createdbefore:, createdafter:, title:, followup:, unorganized:, plus les expressions entre guillemets et les exclusions avec un signe moins.
Relisez cette liste en pensant à une photothèque. Chaque opérateur porte sur l’une de ces trois choses : qui a touché au fichier, quand, ou comment le fichier s’appelle. type:image est le seul terme qui tienne compte des images, et il se contente de restreindre les résultats aux images.
Il n’existe aucun opérateur pour une légende. Aucun pour un mot-clé. Aucun pour un photographe, un sujet, un lieu décrit autrement que par des coordonnées GPS, une licence, une campagne ou un état de validation. Cette absence est le constat. La documentation de référence de Drive dit plus clairement que toute autre source à quoi sert la recherche de Drive : pas à retrouver une image d’après ce qu’elle montre.
La recherche en texte intégral fonctionne, et fonctionne bien, sur ce qui est fait de texte. Un document Google Docs, un PDF avec une couche de texte, un tableur : Drive indexe les mots qu’ils contiennent et les retrouve. C’est pourquoi les équipes dont les bibliothèques sont surtout faites de documents ne remarquent jamais le problème, et pourquoi ces mêmes équipes sont surprises quand le service marketing dit que la recherche ne marche pas.
Ce que Drive lit dans une photo
Ce point mérite d’être précis, car il est documenté et presque jamais cité.
La ressource fichier de l’API Drive de Google définit un objet imageMediaMetadata. C’est l’ensemble complet des propriétés d’image que Drive extrait et stocke. Voici chacun de ses champs :
flashUsed, meteringMode, sensor, exposureMode, colorSpace, whiteBalance, width, height, location (latitude, longitude, altitude), rotation, time, cameraMake, cameraModel, exposureTime, aperture, focalLength, isoSpeed, exposureBias, maxApertureValue, subjectDistance, lens.
Dix-neuf champs. Ouverture, ISO, focale, mode de mesure, balance des blancs, objectif monté. Drive lit dans le détail les réglages de l’appareil photo, et ne lit rien de ce que le photographe a écrit.
Il n’y a aucun champ pour une légende, un titre, un mot-clé, un créateur, une mention de copyright, un crédit ou des conditions d’utilisation. La documentation de l’API ne contient aucun champ IPTC ni XMP d’aucune sorte.
La vidéo est encore plus mince. videoMediaMetadata a trois champs : width, height, durationMillis.
Ce que contient le fichier et que rien n’ouvre
Une photographie contient trois blocs de métadonnées distincts, qui jouent des rôles différents.
L’EXIF est écrit par l’appareil photo. Vitesse d’obturation, ouverture, ISO, objectif, horodatage, parfois GPS. C’est le bloc que lit Drive.
L’IPTC est écrit par des personnes. Le standard de métadonnées photo IPTC est la convention de la presse et des banques d’images que les services photo utilisent depuis des décennies, et il contient les champs qui répondent à une recherche : Description, c’est-à-dire la légende ; Mots-clés ; Créateur ; Mention de copyright ; Crédit ; Conditions d’utilisation des droits ; Lieu sous forme de nom de lieu plutôt que de coordonnées.
Le XMP est le format conteneur d’Adobe, écrit par Lightroom, Photoshop, Bridge et Capture One. Il porte les champs IPTC, plus les notes, les étiquettes de couleur, l’historique des modifications et des schémas personnalisés.
La livraison de tout photographe professionnel contient déjà des IPTC et du XMP renseignés. Cela fait partie de ce que vous avez payé. Les téléchargements d’une banque d’images en contiennent. Dix ans de livraisons d’agences en contiennent. Quand ces fichiers arrivent dans un drive partagé, ce travail devient invisible, parce que rien dans le drive ne le lit, ne l’indexe ni ne l’affiche. La légende est toujours dans le fichier. Il n’y a aucun moyen de la rechercher.
Le résultat concret est une équipe qui saisit des légendes dans les noms de fichiers, ou dans un tableur à côté des noms de fichiers, et recrée à la main les métadonnées que le fichier contient déjà.
Les propriétés personnalisées, et pourquoi elles ne comblent pas l’écart
Drive dispose bien d’un mécanisme pour des métadonnées arbitraires. L’API des propriétés personnalisées de fichier permet à une application d’associer des paires clé-valeur à un fichier, et elles sont interrogeables. Les limites sont publiées :
| Limite | Valeur |
|---|---|
| Propriétés personnalisées par fichier | 100, toutes sources confondues |
| Propriétés publiques par fichier | 30 |
| Propriétés privées par fichier, par application | 30 |
| Taille par chaîne de propriété, clé et valeur ensemble, en UTF-8 | 124 octets |
La dernière ligne est celle qui met fin à l’idée. 124 octets pour la clé et la valeur ensemble. L’exemple de Google lui-même : une clé de 10 caractères laisse 114 caractères pour la valeur.
Une légende ne tient pas en 114 caractères. Une mention de droits d’utilisation non plus, ni une note de plan de prises de vue, ni une liste de mots-clés d’une longueur utile. Vous pourriez stocker un court terme contrôlé, mais il vous faudrait alors une application pour l’écrire, une application pour le lire et une convention que chaque personne qui importe respecte. À ce stade, vous avez commencé à construire une bibliothèque au-dessus d’un système de fichiers, ce qui est un projet d’ingénierie raisonnable mais pas à lancer par accident.
Dropbox n’a aucun modèle comparable de métadonnées descriptives pour les fichiers.
Les quatre index dont une bibliothèque a besoin
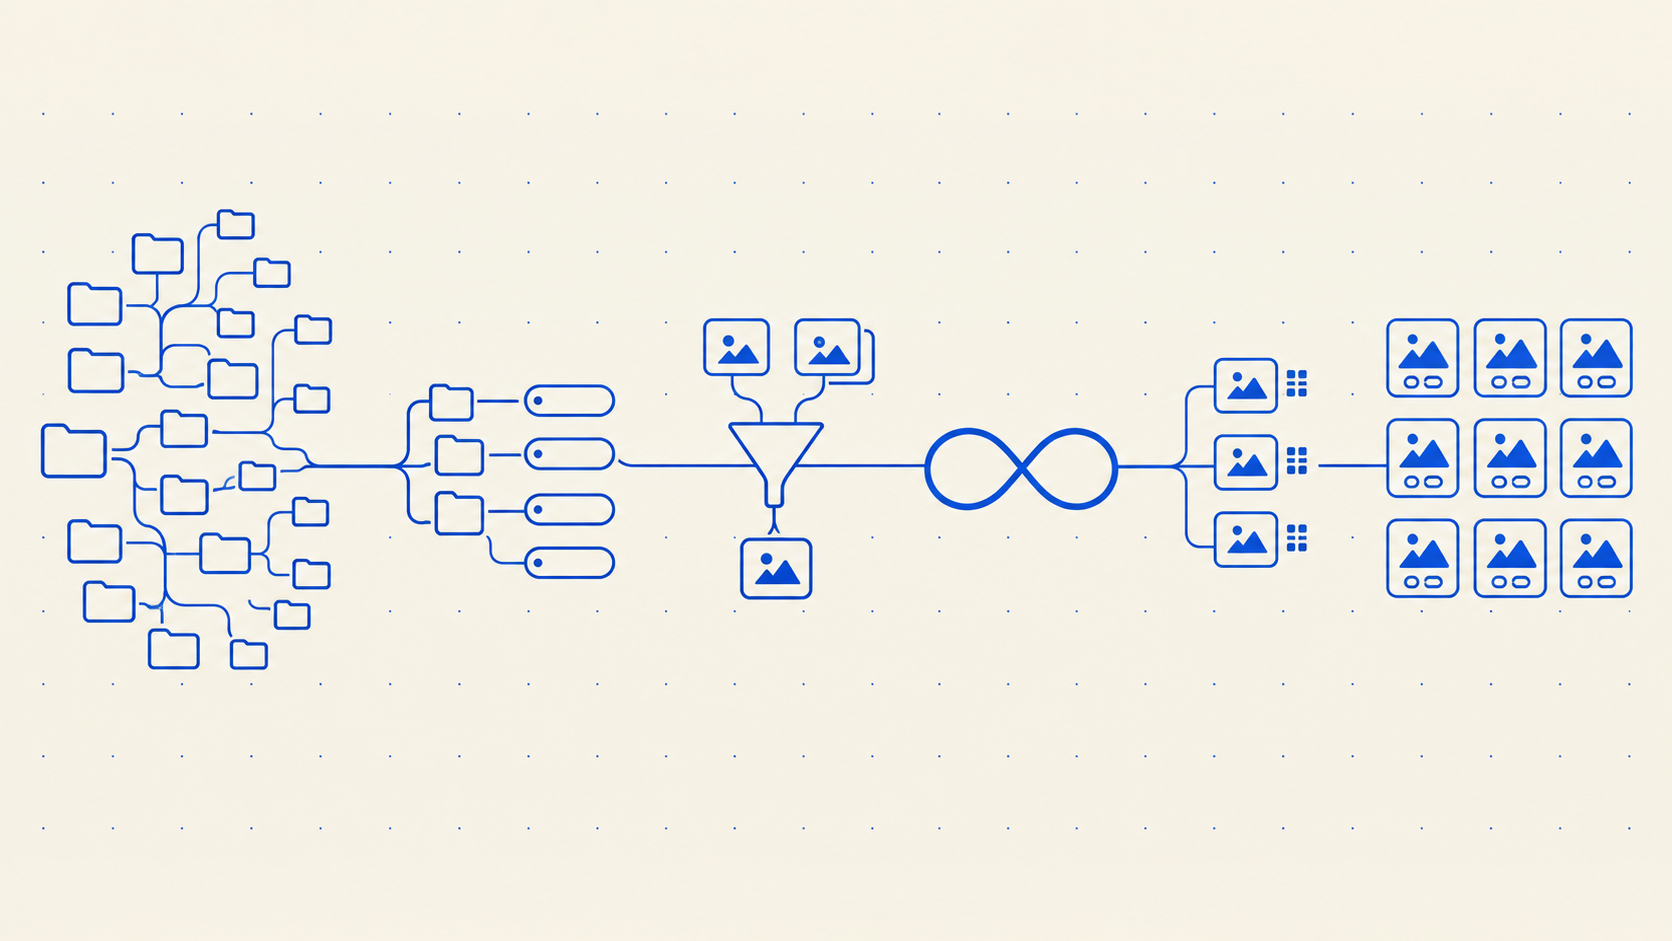
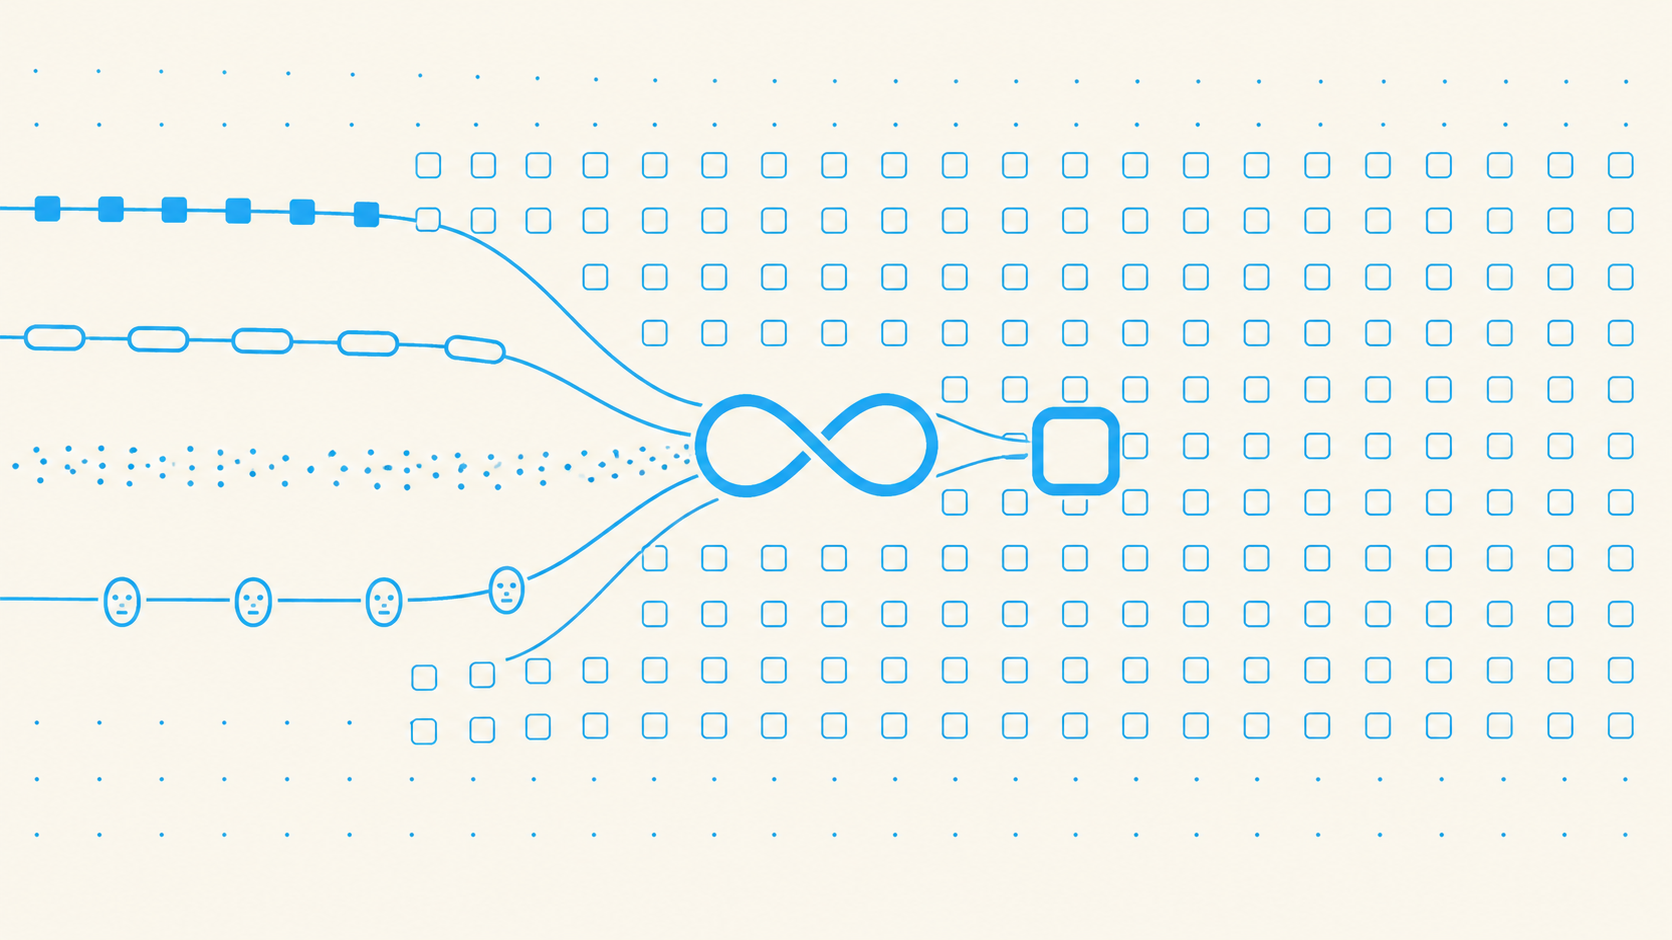
Retrouver une image d’après ce qu’elle contient n’est pas une seule fonction. Ce sont quatre index différents, construits différemment, qui répondent chacun à une question différente et échouent chacun à sa manière. Un système qui en possède un seul et prétend avoir résolu la recherche vous décevra d’une façon précise et prévisible.
Le texte dans l’image
L’OCR lit les mots rendus dans les pixels : le titre d’une affiche, l’étiquette d’un emballage, le nom sur une diapositive, la légende incrustée dans un visuel pour les réseaux sociaux. C’est ainsi que vous retrouvez la campagne dont vous vous rappelez le slogan, mais pas le nom de fichier.
Il échoue sur l’écriture manuscrite, sur les polices très stylisées, sur le texte très incliné et sur les mots présents dans l’image mais pas dans la langue que l’index attend. Il réussit bien plus souvent qu’on ne le croit, car une proportion étonnante de visuels marketing est surtout faite de texte.
Les mots-clés et la taxonomie
Les mots-clés IPTC déjà présents dans le fichier, plus ce que l’organisation ajoute : codes produit, noms de campagne, marché, canal, état de validation. Un vocabulaire contrôlé et une taxonomie les font passer de texte libre à quelque chose qu’on peut filtrer et compter.
Cet index est exact, et c’est le seul qui puisse exprimer un fait qui n’est pas visible sur l’image. Aucune analyse de pixels ne vous dira qu’une photographie est autorisée en Allemagne jusqu’en 2027. Quelqu’un doit l’enregistrer, et c’est dans ce champ que cela va. Le guide des bonnes pratiques de métadonnées explique comment concevoir le schéma.
Il échoue quand personne ne le remplit, d’où la grande valeur des champs que le photographe a déjà écrits.
Le sens
La recherche sémantique convertit l’image et la requête en vecteurs et les compare : « deux ingénieurs sur un site de production » correspond à une photographie qui n’a jamais été décrite avec ces mots. Le mécanisme voisin, la recherche visuelle, prend une image comme requête et trouve les images qui lui ressemblent.
C’est l’index qui répond à la question posée en tête de ce guide. Il échoue sur la précision : il trouvera de façon fiable des photographies de site de production, mais ne distinguera pas de façon fiable celle du rapport de 2024 de celle de 2023. C’est un moyen de ramener 40 000 images à douze, pas d’en isoler une parmi 40 000.
Si c’est l’implémentation qui vous intéresse plutôt que le comportement, la construction de la recherche d’images est l’article d’ingénierie qui la décrit.
Les personnes
La recherche par reconnaissance faciale regroupe les visages d’une bibliothèque pour que toutes les photographies d’une même personne puissent être retrouvées ensemble, que quelqu’un les ait étiquetées ou non. Pour une organisation qui photographie ses propres salariés, clients, intervenants ou sportifs, c’est en général l’index qui a le plus de valeur, car « les photos de cette personne » est la demande la plus courante et celle à laquelle les dossiers répondent le plus mal.
Il échoue sur les visages partiels, sur les enfants qui grandissent et sur les forts changements d’éclairage. Il a aussi des conséquences qui relèvent de la partie 3 : un système capable de retrouver toutes les photographies d’une personne nommée est un système qui doit pouvoir respecter le retrait de consentement de cette personne.
Pourquoi la combinaison compte
Chaque index seul laisse un manque évident. Ensemble, ils répondent en un seul passage à une requête composée : les photographies de cette personne, prises lors de cet événement, dont le texte sur l’image mentionne ce produit, autorisées pour un usage externe, hors quasi-doublons. Aucun index pris seul ne le peut. Une arborescence de dossiers ne s’en approche même pas.
Les quasi-doublons et les onze fichiers appelés « final »
Un drive partagé qui contient hero_final.jpg, hero_final_v2.jpg, hero_FINAL_use_this.jpg et huit autres du même genre est ce qu’on obtient normalement au bout du compte dans une bibliothèque organisée en dossiers. Chacun de ces fichiers est un vrai fichier. Le drive a raison de tous vous les montrer. Il n’a aucun moyen de savoir que dix d’entre eux sont des recadrages, des exports et des variantes de couleur d’une seule photographie, car il compare les noms de fichiers et n’a jamais regardé les pixels.
Une bibliothèque de médias traite cela comme deux problèmes distincts.
La détection des quasi-doublons compare les images par leur contenu, de sorte qu’une copie redimensionnée, recompressée ou légèrement recadrée est reconnue comme la même image arrivée deux fois. C’est un problème de nettoyage et d’import, couvert par la détection des doublons.
Les déclinaisons sont la correction structurelle. Un média, une fiche, un jeu de métadonnées et de droits, avec chaque taille, recadrage et format généré à la demande à partir de lui. Le JPEG pour le web et le TIFF pour l’impression cessent d’être deux fichiers qui peuvent se contredire et deviennent deux vues d’un même objet. Quand les droits changent, ils changent une seule fois.
À quoi ressemble une bibliothèque qui fonctionne
Deux contrôles que vous pouvez faire sur n’importe quelle bibliothèque, y compris la vôtre.
Le test du nouvel arrivant. Donnez à quelqu’un arrivé le mois dernier une demande formulée comme le ferait un collègue : « la photo du nouvel emballage sur fond blanc, en format paysage, que nous avons validée pour l’impression ». Chronométrez. S’il ne la trouve qu’en demandant à quelqu’un, l’index de la bibliothèque est la mémoire d’un collègue.
Le test de la légende. Prenez une photographie livrée par un professionnel au cours des deux dernières années. Ouvrez ses propriétés de fichier dans Lightroom, Bridge, Photoshop ou l’inspecteur de l’Aperçu de macOS. Lisez les champs Description et Mots-clés. Puis cherchez dans votre bibliothèque un mot distinctif de cette légende. Si rien ne revient, les métadonnées que vous avez déjà payées ne sont pas utilisées.
Questions fréquentes
La recherche de Google Drive fonctionne-t-elle à l’intérieur des images ?
La liste publiée des opérateurs de recherche de Drive couvre le propriétaire, les dates, le type de fichier et le titre, et ne contient aucun opérateur pour les métadonnées ou le contenu des images. L’API de Drive extrait dix-neuf réglages d’appareil photo d’une photographie, comme l’ouverture, l’ISO et l’objectif, mais aucun champ descriptif : ni légende, ni mots-clés, ni créateur, ni copyright. Drive retrouve les images par leur nom de fichier, par leur propriétaire et par leur date d’ajout.
Puis-je rechercher dans Google Drive par mots-clés IPTC ?
Non. La ressource fichier de Drive n’a aucun champ IPTC ni XMP. Les mots-clés qu’un photographe a écrits dans le fichier s’y trouvent toujours, mais ne sont pas indexés. L’API des propriétés personnalisées de Drive peut stocker vos propres paires clé-valeur, mais chaque chaîne de propriété est limitée à 124 octets, clé comprise, ce qui est trop petit pour une légende ou une liste de mots-clés d’une longueur quelconque.
Quelle est la différence entre EXIF et IPTC ?
L’EXIF est écrit par l’appareil photo et décrit l’exposition : vitesse d’obturation, ouverture, ISO, objectif, horodatage, parfois GPS. L’IPTC est écrit par des personnes et décrit le contenu et les droits : légende, mots-clés, créateur, mention de copyright, crédit, conditions d’utilisation. Drive lit l’EXIF. Une bibliothèque de médias lit les deux, et recherche sur l’IPTC.
Comment rechercher des images par leur contenu ?
Avec quatre index, utilisés ensemble. L’OCR lit le texte rendu dans l’image. Les mots-clés et la taxonomie contiennent les faits qui ne sont pas visibles, comme les droits et la validation. La recherche sémantique et visuelle fait correspondre le sens et l’apparence, de sorte qu’une description trouve une image que personne n’a décrite ainsi. Le regroupement de visages rassemble toutes les photographies d’une même personne. Chacun a son propre mode d’échec, ce qui explique pourquoi un système qui n’en a qu’un seul paraît peu fiable.
Mieux nommer les fichiers résoudra-t-il le problème ?
Cela aide, mais cela ne passe pas à l’échelle. Une convention de nommage est un accord partagé qui n’existe que dans la tête de ceux qui l’ont rédigée. Elle survit à une équipe et ne survit pas à une nouvelle recrue, à un deuxième site, à une agence ou au jour où quelqu’un est pressé. Elle ne peut pas non plus exprimer ce qui change avec le temps, comme une validation qui expire ou une licence qui arrive à échéance.
Prochaine partie de la série : liens de partage, droits et piste d’audit. Partie précédente : les limites publiées. La recherche de Freedam fait fonctionner les quatre index sur la même bibliothèque.